Meta Muse 是 Meta 公司推出的个人 AI 智能体(Agent),定位为能够代替用户执行实际任务的“办事型”助手,而非传统的问答工具。2026 年 9 月上线后,它迅速登顶美国 App Store 免费榜,成为 Meta 在 AI 领域追赶 OpenAI 和谷歌的关键产品。
Muse 与 ChatGPT 等产品的本质区别在于产品逻辑。扎克伯格曾明确界定:ChatGPT 是用户提问、获得答案、任务结束;而 Muse 的逻辑是用户设定一个目标,它会在后台持续运作,自行拆解任务、打开网页、填写表单、调用外部应用,直到目标达成为止。
为了实现这一点,每个用户拥有一台云端专属虚拟机(Muse Secure VM),即使关闭 App,任务仍可在后台继续执行。Muse 能够完成的具体任务包括:撰写和发送邮件、安排日程、预订旅行和餐厅、网购下单、填写网页表格、参与账单谈判,甚至协助出售汽车。
Muse 的能力基础是 Meta 的 Muse Wonder 系列模型。2026 年 10 月,Meta 发布了 Muse Wonder 和 Muse Wonder Full 两款模型,称其为“迄今为止最强大的模型”,标志着 Meta 正式进入 AI 前沿阵营。
| 模型 | 定位 | 可用渠道 |
|---|---|---|
| Muse Wonder | 标准版,通过 API 提供 | Meta Model API、Muse Code |
| Muse Wonder Full | 最强版本,仅限订阅 | Muse Code 的 Power/Maximum Usage 订阅 |
两款模型均支持软件开代、多步骤规划、工具调用以及图像、文档、视频分析,能够调试代码、在大规模项目中做修改,并从错误中恢复。训练在 Meta 位于俄亥俄州的 Prometheus 数据中心完成,该数据中心具备吉瓦级规模。
Active Memory(主动记忆) 让模型能够跨对话保留用户的 relevant 信息,并在需要时回忆起来。Meta 研究员表示,团队投入了大量精力确保模型能记住关于用户的重要信息“数天、数周、数月之久”。这一特性对长期运行的个人 Agent 至关重要。
Active Focus(主动聚焦) 帮助模型在困难任务上持续推进,在一种方法失败时尝试替代路径,并在执行重要操作前向用户请求确认。
Muse 的爆发速度相当惊人。上线不到两周即登顶美国 App Store 免费榜;12 天内美加地区下载量约 280 万次,超过 ChatGPT 同期表现。美国移动端日活约 64.2 万,是 ChatGPT 上线同期 23.1 万的近三倍。Meta 股价在此期间累计涨幅超过 20%,市值增加约 2000 亿美元。
在基准测试方面,Muse Wonder Full 在 Artificial Analysis 智能指数上得分 56,与 Claude Sonnet 5.5 持平,略高于 GPT-6 Astra 和 Gemini 4 Argon;标准版 Muse Wonder 得分 52。Meta 的 MemoryBench 测试中,Muse Wonder 的记忆能力也优于 Fable、Opus 和 Astra。
不过,竞争压力同样明显。谷歌的 Gemini 4 Argon 在一般智能上与 Wonder 基本持平,但在法律任务(Harvey Legal Agent Benchmark 上 19.6% vs Wonder 的 10.0%)和幻觉控制(15% vs Wonder 的 26.5%)上明显领先。Meta 在基准测试的选择上也受到批评——Argon 被排除在 Meta 的发布对比之外。
Muse Wonder 通过 API 的价格为 $4/百万输入 token,$20/百万输出 token,与 Claude Opus 5.5 的定价一致,低于 Fable 5.1 的 $10/$50。Muse 本身提供免费版和付费版($20/月或$100/月),付费版提供更多算力。
扎克伯格设想的长期商业模式并非主要依赖订阅,而是 从 Muse 促成的商业交易中抽取小额佣金。Meta 计划提供每周 1 亿 token 的免费算力,让多数用户免费使用,佣金由合作商家承担。
隐私问题是 Muse 面临的最大质疑。Meta 自身的安全数据显示,Muse Wonder 在处理个人信息时的失误率约为 3.4%(约三十分之一),虽然优于 GPT-6 Astra 和 Fable 5.1,但对于涉及健康、财务等敏感数据的个人 Agent 而言,这一错误率仍然偏高。Futurum 的调查显示,安全与数据隐私是企业在部署 Agentic AI 时的首要顾虑,且不会随经验积累而消退。
此外,已有报道显示有用户授权 Muse 代理处理 Facebook Marketplace 的销售,但未意识到系统会将其家庭地址提供给买家,引发了对 Agent 权限边界的安全担忧。
开源策略的转变也值得注意。与 Llama 时代的开源路线不同,Muse Wonder 是闭源模型,仅通过 Meta 自有渠道提供。Wonder Full 甚至不通过 API 开放,企业无法基于它构建生产应用。这使 Meta 在直接与 OpenAI、Anthropic 和谷歌的企业级竞争中处于劣势——这些公司拥有 Meta 所缺乏的多年企业销售、支持和合规能力。
免责声明:本网站仅提供网址导航服务,对链接内容不负任何责任或担保。

4 天前
AI 智能体的技能包管理器
3 个月前
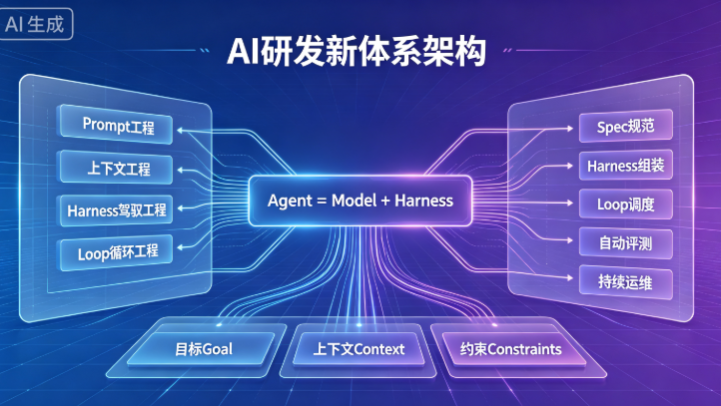
AI 研发已从单点 Prompt 优化迭代至Harness 工程底座 + Loop 自治闭环 + SDD 标准化规范的三位一体体系,通过重构人机协作模式,解决大模型落地不稳定、难规模化的痛点,实现企业级 AI 从原型试用走向工程化、自动化、体系化落地。
3 个月前
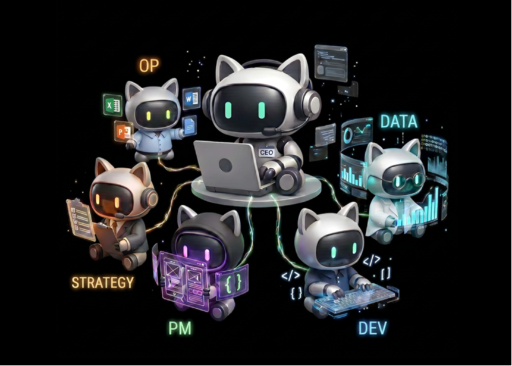
WorkBuddy有望拿下国内独立桌面自动化办公智能体细分第一。但受企业协同生态、移动端能力等短板限制,无法成为全域企业及全球办公AI赛道第一名,将与钉钉悟空、WPS AI形成差异化竞争格局。
3 个月前
OpenClaw工具与生态完整生命周期判断 本文尝试分短期、中期、长期三段,结合项目现状、风险、护城河客观测算OpenClaw这款智能体工具或者相似工具的发展趋势。 一、短期生命力(1~3年,2026–2029):完全安全、高速增长,是黄金运营窗口期 支撑理由 赛道刚需独一无二,差异化壁垒极强 OpenClaw是极少数本地系统级执行、模型无关、纯自托管的终端Agent运行框架,定位“能操作电脑文件、软件、桌面的AI助手”,区别于LangGraph/CrewAI这类后端开发框架、AutoGPT纯实验型智能体。普通办公、个人自动化、小微企业没有替代同类成熟开源工具,C端+中小企业需求持续释放。 社区与生态飞轮已经跑通 GitHub 30万+星标、近千名全球持续贡献者,日均数百条PR/Issue迭代,更新频率行业第一;创始人Peter全职维护,大厂(英伟达、Kimi、MiniMax)主动适配接入; ClawHub官方技能仓库沉淀数千标准化Skill,国内衍生生态(xia345、各类中文技能站、私有化二次改版)持续扩容,形成标准锁定; MIT宽松开源协议,允许企业二次改造、搭建托管服务,大量服务商入局完善配套生态(部署、安全加固、私有化定制)。 行业周期红利:本地终端Agent处于普及早期 2026被行业定义为桌面Agent落地元年,云端大模型成本持续下行、本地Ollama离线模型普及,完美匹配OpenClaw“本地优先”架构;未来3年,个人自动化、企业内网办公自动化需求只会扩张。 短期仅有的可控风险 Token调用成本偏高、频繁更新易出现版本兼容bug、本地高权限带来安全隐患; 以上问题官方正在持续迭代修复,企业级备份、权限沙箱、日志审计功能已逐步补齐,属于可优化痛点,不会动摇存续根基。 结论:未来1–3年是生态最繁荣、流量最大、变现最顺畅的阶段。 二、中期生命力(3~7年,2029–2033):稳定存续,但竞争加剧、增速放缓 存续核心逻辑 标准化生态具备长期锁定效应 SKILL.md、ClawHub统一技能规范、openclaw CLI命令行已经形成行业事实标准。就算出现竞品,开发者、存量数万套技能、企业定制项目迁移成本极高,生态不会短时间崩塌,会维持稳定使用人群。 分层商业模式支撑项目持续维护 原生项目开源免费,但周边商业化闭环成型:企业私有化部署服务、安全审计、托管云服务、垂直行业技能付费、模型渠道分销,持续产生现金流反哺社区开发,不会出现“没人维护停更”的局面。 使用人群分层留存 C端极客、办公自动化爱好者会长期使用; 中小企业内网自动化、数据处理场景高度依赖本地执行Agent,大厂SaaS Agent无法满足内网隐私需求; 开发者持续基于OpenClaw做二次分支、私有化改版,衍生生态会持续分流、延续整个“龙虾生态”的热度。 中期衰减变量(会降低增速,但不会淘汰项目) 微软、苹果、国产操作系统推出原生系统级AI助手,抢占普通小白用户; 新轻量化终端Agent开源框架分流开发者; 各国监管对本地高权限AI自动化工具出台更严格合规要求,提高企业落地门槛; 结论:3–7年不会消亡,但行业从爆发期进入存量竞争,流量红利收窄,平台需要深耕私有化、企业定制、垂直细分赛道才能持续盈利。 三、长期生命力(7年以上,2033之后):分两种极端走向 走向1:长期持续存活(概率60%),变成基础设施级工具 如果行业发展符合以下趋势,OpenClaw会像现在的Python、Git一样长期存续: 终端自主Agent成为电脑标配生产力工具,本地执行、离线隐私是永久刚需; OpenClaw持续完成企业级、合规化改造,成为政企内网自动化标准选型; 社区形成基金会/商业公司承接维护,摆脱单一创始人依赖,实现长久开源运营。 走向2:逐步边缘化、被新一代架构替代(概率40%) 触发条件: 操作系统底层内置标准化Agent执行层,统一API,第三方独立运行框架失去生存空间; 多模态、具身智能技术迭代,全新架构完全替代“技能+本地脚本执行”模式; 全球监管全面限制本地高权限自主AI工具,商用落地基本锁死,仅小众极客圈子留存。 即便被边缘化,存量存量技能、配套站点、私有部署项目仍会维持5–10年长尾生命周期,不会瞬间彻底消失。 四、关键风险:会大幅缩短生命周期的致命隐患 安全重大事故 若出现大规模Skill供应链投毒、批量本地数据泄露事件,企业端市场会快速萎缩,仅保留个人玩家生态;官方正在完善自动病毒扫描、技能审核机制,风险持续降低。 创始人断更、无承接主体 当前项目由Peter单人主导,若后续精力转移、无商业公司接手维护,迭代速度断崖式下滑,竞争力快速落后竞品;目前已有多家AI服务商、模型厂商深度合作,存在接手预期。 算力成本长期居高不下 如果大模型API按量价格无法大幅下降,普通用户长期使用成本过高,会劝退大众用户,仅留存企业付费群体。 国内政策监管收紧 国内针对本地自主自动化工具出台限制,国内衍生生态、配套导航平台流量大幅下滑,但海外生态不受影响。 五、综合最终总结 0–3年(黄金期):放心投入建站、填充内容、运营变现,生态高速扩张,流量红利充足; 3–7年(平稳期):生态稳定存在,竞争变多,需要走差异化(私有化、离线、海外双语)路线维持竞争力; 7年以上(分化期):要么成为长期基础设施永续存在,要么逐步小众长尾,即便衰退也有数年缓冲时间; 整体安全底线:至少拥有5年以上稳定商业运营周期,足够覆盖站点开发、回本、盈利完整周期;中长期只要避开通用综合赛道,主打本地离线私有化细分,生命周期会进一步拉长。

7 个月前
OpenClaw 本质是“开发者基础设施”,而非面向大众的 SaaS 产品。

7 个月前
用 OpenClaw 搭建一个本地 Agent 中枢(完整方案) 不是再做一个 ChatGPT,而是建立一个真正“可控、可组合、可扩展”的本地 AI Agent 中枢。 当越来越多团队开始意识到: 云端 LLM 成本不可控 数据隐私存在风险 单一 Agent 无法解决真实业务 “本地 Agent 中枢” 正在成为一个更现实的选择。 本文将完整讲清楚: ? 如何用 OpenClaw 搭建一个真正可用的本地 Agent 中枢 ? 它适合谁,不适合谁 ? 与 LangGraph / CrewAI 的核心差异 什么是「本地 Agent 中枢」? 先明确一个概念,避免误解。 ❌ 不是: 一个本地 ChatGPT 一个简单的 Prompt 管理器 ✅ 而是: 一个能够统一管理多个 Agent、模型、工具和任务流程的本地系统 一个合格的本地 Agent 中枢,至少要解决 5 件事: 多 Agent 协作(不是单轮对话) 任务调度与状态管理 模型可替换(本地 / API) 工具调用(搜索、代码、文件等) 可长期运行、可追溯 OpenClaw 的定位,正是这个“中枢层”。 为什么选择 OpenClaw? 在进入部署前,必须先回答一个现实问题: 为什么不是 LangGraph / CrewAI / AutoGen? 简要结论(非常重要) 框架 更适合 LangGraph 开发者写 Agent 流程 CrewAI 小规模角色协作 AutoGen 对话驱动实验 OpenClaw 长期运行的 Agent 中枢 OpenClaw 的核心优势 1️⃣ 架构清晰,不是“脚本拼装” 有明确的 Agent 管理层 有任务执行与状态机制 不是写完一次就丢的 Demo 2️⃣ 原生支持多模型策略 本地模型 云 API fallback / 优先级策略 3️⃣ 更接近“生产环境思维” 可持续运行 可复用 Agent 可演进 如果你的目标是: “做一个长期使用的 AI 中枢,而不是一段实验代码” 那 OpenClaw 是目前更合理的选择之一。 整体架构:OpenClaw 本地 Agent 中枢怎么搭? 这是一个最小可用但可扩展的架构方案。 ? 架构拆解 ┌─────────────────────────┐ │ 用户 / 系统 │ └──────────┬──────────────┘ │ ┌──────────▼──────────┐ │ OpenClaw 中枢层 │ │ - Agent Registry │ │ - Task Orchestrator│ │ - Memory / State │ └──────────┬──────────┘ │ ┌─────────▼─────────┐ │ Agent 集群 │ │ - Research Agent │ │ - Coding Agent │ │ - Planning Agent │ │ - Tool Agent │ └─────────┬─────────┘ │ ┌─────────▼─────────┐ │ 模型 & 工具层 │ │ - 本地 LLM │ │ - API LLM │ │ - Search / FS / DB │ └───────────────────┘ 部署准备(实战级) 1️⃣ 基础环境 推荐环境(已验证): Linux / WSL / macOS Docker + Docker Compose Python 3.10+ 2️⃣ 模型选择建议(非常现实) 场景 推荐 本地推理 Qwen / LLaMA 稳定输出 GPT / Claude API 混合方案 本地 + API fallback ? 关键不是模型多,而是“可切换” 核心步骤:搭建 OpenClaw 本地 Agent 中枢 Step 1:部署 OpenClaw 核心 git clone https://github.com/xxx/openclaw cd openclaw docker compose up -d 启动后,你将拥有: Agent 管理入口 任务调度服务 统一配置中心 Step 2:定义你的第一个 Agent 一个 Agent ≠ 一个 Prompt 而是一个职责明确的“角色” 示例: agent: name: research_agent role: 信息调研 model: local_llm tools: - web_search - file_reader 建议起步 Agent: Research Agent(信息收集) Planner Agent(任务拆解) Executor Agent(执行) Step 3:建立 Agent 协作流程 例如一个典型任务: “调研某行业 → 输出分析 → 给出建议” 流程是: Planner 拆解任务 Research Agent 收集信息 Executor Agent 输出结果 中枢保存状态与结果 ? 这一步,才是“中枢”的价值所在 一个真实可用的示例场景 ? 场景:AI 工具评估中枢 你可以搭一个 Agent 中枢来做: 自动收集 AI 工具信息 对比功能 / 定价 输出结构化报告 长期更新 这类系统: 人工成本极高 用 Agent 非常合适 总结:什么时候该用 OpenClaw? 当你意识到:AI 不再是“一次性回答”,而是“持续协作的系统” 那你就已经走在 OpenClaw 这条路上了。 OpenClaw 不是让你“更快用 AI”,而是让你“真正拥有 AI 能力”。
7 个月前
Asking User Question Tool(AI智能体版) 这是AI智能体必备的交互式工具,让Agent在执行任务时主动向用户提问、澄清需求、收集信息,避免瞎猜、减少返工、提升准确率。 一、核心定位 本质:Agent的“人在回路”交互接口,让AI在模糊/信息不足时暂停执行,向用户要明确输入。 作用:把“模糊指令→AI瞎做→反复修改”变成“AI提问→用户明确→一次做对”。 常见名称: AskUserQuestion 、 AskUserQuestionTool 、 ask_user_question 。 二、核心工作流(极简) 1. Agent判断信息不足:发现需求模糊、缺少参数、需要决策 2. 调用工具生成结构化问题:单选/多选+自定义输入+说明 3. 用户作答:在聊天/弹窗/终端选择或输入 4. Agent接收答案:解析结构化结果,补全上下文 5. 继续执行任务:基于完整信息推进,不再猜 三、关键能力(标配) 结构化提问:标题+问题+2–4个选项+单选/多选+ Other 自定义输入 上下文澄清:自动追问,直到需求完全明确 结构化返回:输出JSON,方便前端渲染(按钮/表单/弹窗) 人在回路:强制用户确认,避免AI自主决策风险 多轮交互:可连续提问,形成“需求访谈”流程 四、主流实现(你会遇到的版本) Claude Code(Anthropic) 原生内置,最成熟 支持多轮、单选/多选、自定义输入 常用于代码生成、需求梳理 Qwen-Agent(通义千问) 开源工具: qwen_agent/tools/ask_user_question.py 支持参数: question / options / explanations / multiSelect / allowFreeform Spring AI AskUserQuestionTool ,Java生态 模型无关,可对接GPT/Claude/Gemini OpenClaw / EasyClaw 集成到本地智能体,用于任务执行前确认 本地运行,隐私优先 五、典型使用场景(高频) 需求澄清:“做一个登录页”→AI问:技术栈?风格?是否第三方登录? 偏好收集:“写报告”→AI问:正式/ casual?长度?受众? 决策点确认:“部署服务”→AI问:云厂商?实例规格?环境? 复杂任务拆解:多轮提问,把模糊需求变成可执行步骤 六、与普通聊天的区别 普通聊天:用户主动说,AI被动答;信息靠用户自己补全 AskUserQuestion:AI主动问、结构化问、按任务节点问;用户只需点选/填空,效率高、歧义少 七、为什么要用(价值) 减少返工:一次做对,节省时间与Token 提升准确率:AI不瞎猜,结果更贴合需求 降低门槛:用户不用写长Prompt,点选即可 安全可控:关键决策必须用户确认,避免误操作 八、一句话总结 Asking User Question Tool = AI智能体的“需求访谈官”,让Agent从“猜着做”变成“问清楚再做”,是构建可靠、实用AI助手的核心工具。

8 个月前
部署本地 OpenClaw 主要有两种主流且资料详尽的方式,你可以根据自己的技术背景和需求来选择。 我把这两种方式的流程整理成了一个概览表格,方便你快速对比和决策: 特性 方案一:Docker 部署(推荐新手) 方案二:Node.js 源码部署(适合开发者) 核心依赖 Docker, Docker Compose, Git Node.js (≥22), npm, Git 优点 环境隔离,部署和卸载干净,失败率低,适合快速体验 配置灵活,方便二次开发和调试,可直接运行最新源码 缺点 需要了解基本的 Docker 命令 对系统环境要求较高,可能遇到依赖冲突 适用人群 希望快速、稳定运行OpenClaw的用户 开发者、希望修改源码或深度定制OpenClaw的用户 方案一:使用 Docker 部署(推荐) 这种方法将 OpenClaw 运行在容器中,与你的系统环境隔离,最为稳妥。 第1步:准备工作与环境检查 在开始之前,请确保你的电脑满足最低要求:CPU ≥ 2核,内存 ≥ 4GB,磁盘空间 ≥ 20GB 。 第2步:安装通用依赖 你需要安装 Docker、Git 等工具。以下是 Linux (Ubuntu/Debian) 的示例命令,Windows 用户请手动下载安装 Docker Desktop 和 Git 。 # 1. 安装 Docker (使用阿里云镜像加速) curl -fsSL https://get.docker.com | bash -s docker --mirror Aliyun # 2. 启动 Docker 并设置开机自启 sudo systemctl start docker sudo systemctl enable docker # 3. 验证 Docker 安装 docker --version && docker compose version # 4. 安装 Git sudo apt update && sudo apt install git -y git --version 第3步:获取 OpenClaw 源码与镜像 创建工作目录,并拉取汉化版的源码和预构建的 Docker 镜像 。 # 1. 创建并进入部署目录 mkdir -p /opt/openclaw && cd /opt/openclaw # 2. 拉取2026版OpenClaw源码(汉化版) git clone https://github.com/openclaw-community/openclaw-zh.git . # 3. 拉取OpenClaw核心镜像(国内加速源) docker pull registry.cn-hangzhou.aliyuncs.com/openclaw/openclaw-core:2026-zh docker pull registry.cn-hangzhou.aliyuncs.com/openclaw/openclaw-web:2026-zh # 4. 验证镜像拉取结果 docker images | grep openclaw 第4步:初始化配置文件 复制配置文件模板并进行修改,填入你的 API Key 等重要信息 。 # 1. 复制默认配置文件 cp config/example.yaml config/config.yaml # 2. 编辑配置文件 (这里使用nano,你也可以用vim) nano config/config.yaml 找到文件中的对应部分,修改为以下内容。请务必将 你的阿里云百炼API-Key 替换为你自己的密钥 。 # ① 模型配置(替换为你的API-Key) models: providers: bailian: apiKey: "你的阿里云百炼API-Key" # <-- 在这里填入你的Key model: "bailian/qwen3-max-2026-01-23" # ② 服务端口配置 server: port: 18789 host: "0.0.0.0" # 监听所有网络接口,方便局域网内访问 # ③ 数据存储配置(本地路径) storage: local: path: "/opt/openclaw/data" 保存文件 (nano 中按 Ctrl+X,然后按 Y 确认,再按 Enter)。 第5步:启动 OpenClaw 服务 使用 Docker Compose 启动服务,并检查运行状态 。 # 1. 启动服务(后台运行) docker compose up -d # 2. 查看服务启动状态(所有容器应为 "Up" 状态) docker compose ps # 3. (可选)查看启动日志,确保无错误 docker compose logs -f 第6步:访问并完成初始化 打开浏览器,访问 http://127.0.0.1:18789 (如果在本机) 或 http://你的局域网IP:18789。首次访问时,页面会引导你设置管理员密码,之后就可以开始使用你的 OpenClaw 了 。 方案二:使用 Node.js 从源码部署 这种方式更贴近开发环境,适合需要定制功能的用户。 第1步:安装 Node.js 环境 OpenClaw 需要 Node.js 22 或更高版本 。推荐使用 NodeSource 仓库进行安装。 # 1. 添加 NodeSource 仓库 (以 Node.js 22 为例) curl -fsSL https://deb.nodesource.com/setup_22.x | sudo -E bash - # 2. 安装 Node.js sudo apt install -y nodejs # 3. 验证安装 node -v # 应显示 v22.x.x 或更高 npm -v # 4. (可选) 配置 npm 国内镜像加速 npm config set registry https://registry.npmmirror.com 第2步:安装 OpenClaw 官方提供了一个一键安装脚本,会自动完成全局安装 。 # macOS / Linux 系统执行 curl -fsSL https://openclaw.ai/install.sh | bash 安装脚本执行完成后,会自动进入一个名为 onboard 的交互式设置向导。如果向导中断,你可以随时通过 openclaw onboard --install-daemon 命令重新启动 。 第3步:处理可能遇到的问题 command not found 错误: 安装后如果找不到 openclaw 命令,通常是因为 npm 的全局安装目录不在系统的 PATH 环境变量中。你可以通过 npm prefix -g 找到该目录(例如 /usr/local),然后将 export PATH="$(npm prefix -g)/bin:$PATH" 添加到你的 ~/.bashrc 或 ~/.zshrc 文件中,并执行 source ~/.bashrc 使其生效 。 sharp 模块安装失败: 在某些系统上,可能会遇到图像处理库 sharp 的安装错误。可以尝试设置环境变量绕过本地编译:SHARP_IGNORE_GLOBAL_LIBVIPS=1 npm install -g openclaw@latest 。 第4步:运行 OpenClaw 完成配置后,你可以通过以下命令启动 OpenClaw 的 Gateway 核心服务 : openclaw gateway 然后,打开浏览器访问 http://127.0.0.1:18789 即可看到 Web 控制台界面 。 总的来说,对于大多数想要本地尝鲜的朋友,我强烈建议使用 Docker 方案,它足够简单且不容易把系统环境弄乱。如果你是个喜欢折腾的开发者,希望深入定制 OpenClaw 的能力,那么 Node.js 源码部署会更适合你。