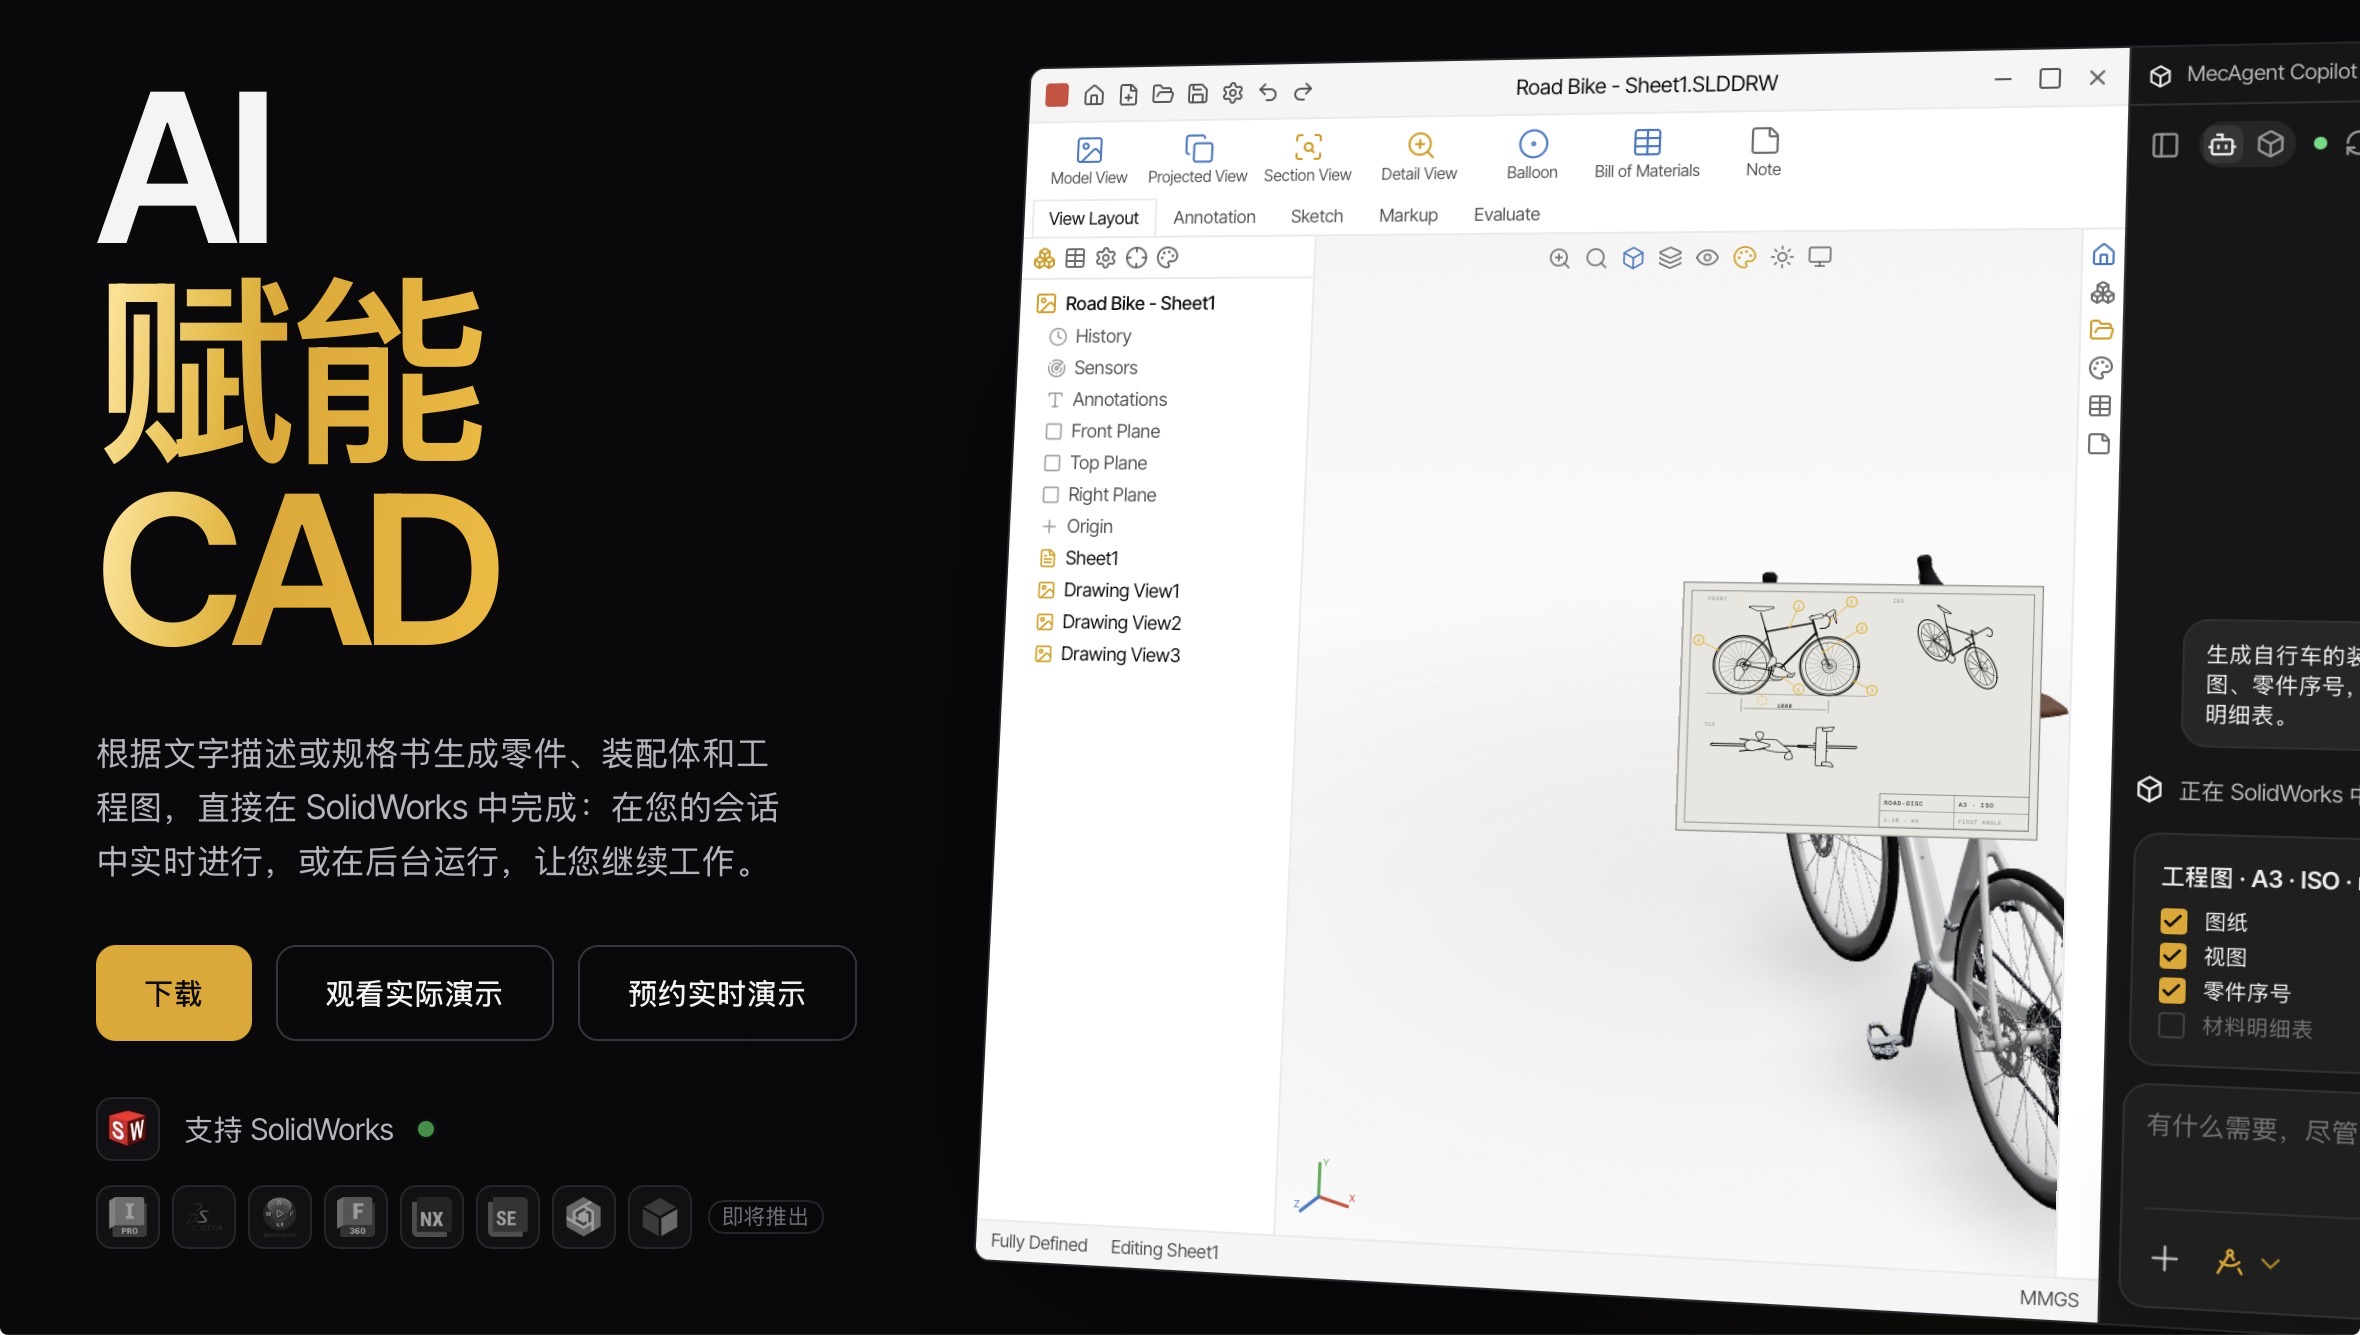
MecAgent 是面向机械工程师的 AI CAD Copilot(CAD智能副驾/AI智能体),定位不是替代CAD软件,而是作为插件嵌入现有CAD环境,用自然语言驱动CAD自动化、建模、工程文档与标准校验,由海外初创公司开发,已完成300万美元融资,通过SOC2安全认证,保护工程图纸IP安全。
在SolidWorks / Autodesk Inventor内直接运行;未来计划支持CATIA、Fusion360、NX、Creo、Onshape等主流CAD。
原理:大模型把自然语言需求自动生成CAD宏(Macro),再由宏在CAD里执行批量操作,工程师不用学习VBA/API编程。
AI宏生成(最核心能力)
自然语言描述任务,自动生成CAD宏脚本,实现批量自动化:批量导出STEP/DXF/PDF、批量改零件属性、统一命名、批量改特征(如全装配体批量改圆角)、批量出图、钣金展开导出等,不懂代码也能做CAD自动化。
AI工程图纸生成(AI Drawing)
从3D模型一键生成2D工程图,自动投影视图、标题栏、标注、明细表;适合加工图纸(GD&T等复杂企业定制标注暂不完全覆盖)。
Text-to-CAD / Specs-to-CAD
文字描述零件/草图,直接生成可编辑参数化3D模型;独立云功能可输出STEP/STL文件,把设计规格转成可制造三维模型。
AI机械工程专家问答
内置ISO、ASME标准、供应商手册等权威工程知识库,在CAD内直接提问:强度校核、螺栓连接、壁厚、齿轮模数等计算,回答附带原文出处引用,可做合规检查、错误检测、实时成本估算(按几何、材料、工艺估算加工成本)。
CAD知识库与智能文件检索
用文字/草图检索企业内部海量CAD图库;自动清理STEP导入模型、标准化零件iProperty属性,整理老旧图纸资产。
完成SOC 2 Type I审计,本地插件+云端分离,工程文件知识产权隔离保护,适合工业企业使用。
免责声明:本网站仅提供网址导航服务,对链接内容不负任何责任或担保。
1 个月前
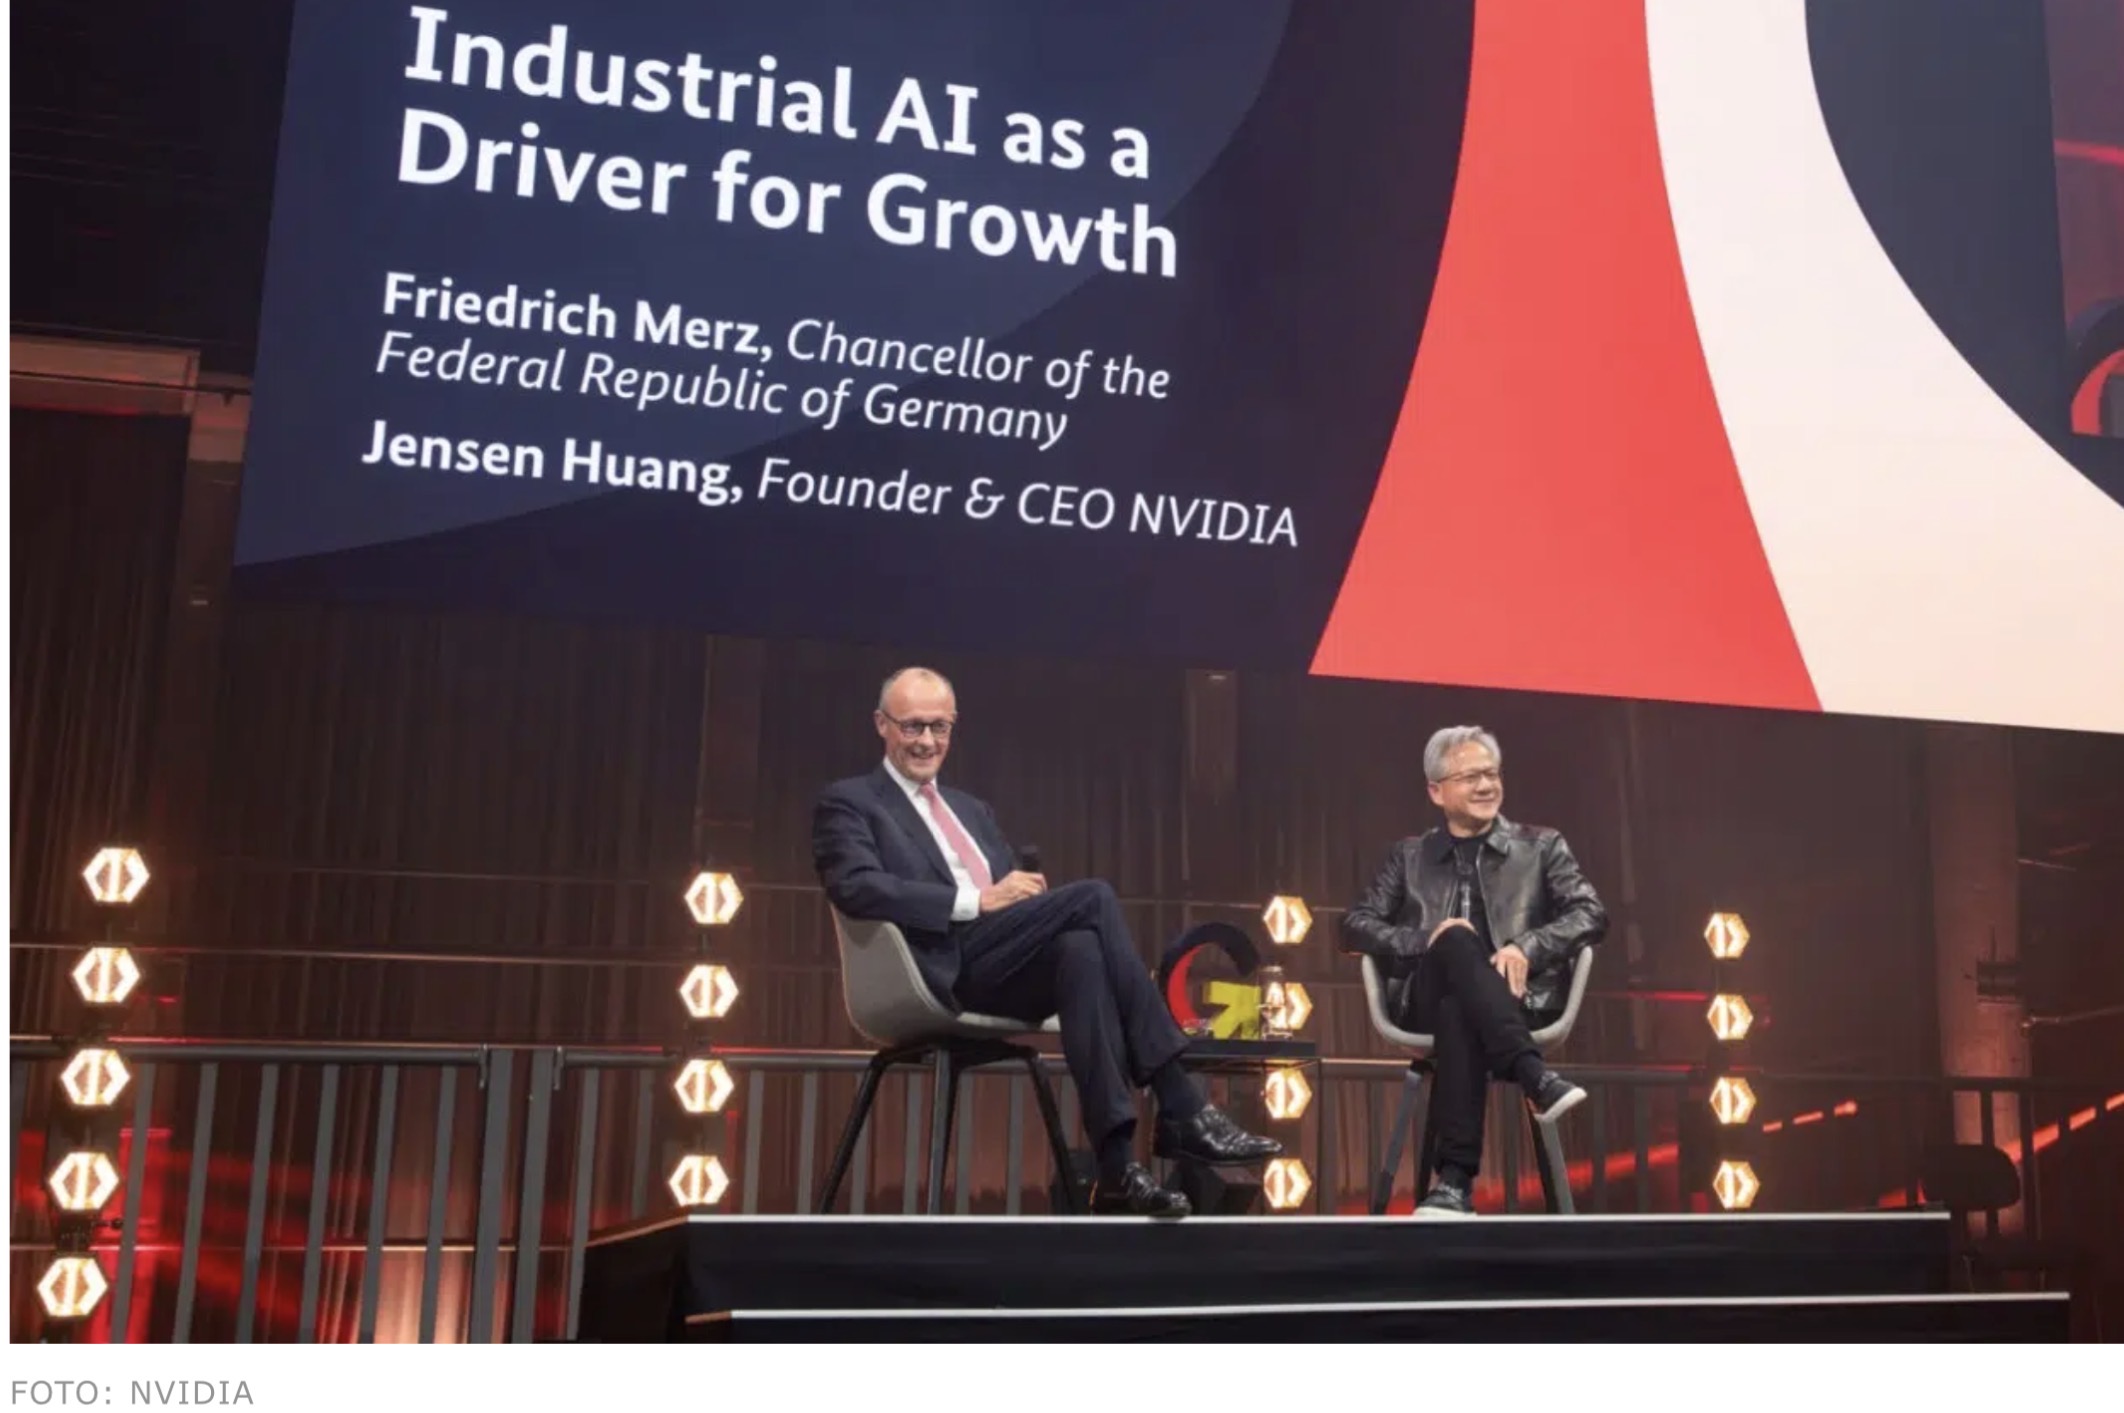
“如果技术不存在,就无从监管。” 黄仁勋进一步强调,如果AI产业无法蓬勃发展,“那就没什么可监管的了”。
1 个月前
很多人以为 AI 时代的终局是“无人工厂”。黄仁勋在柏林给的版本,温柔得多,也更德国:电子不取代原子;它让原子被理解得更深。
1 个月前
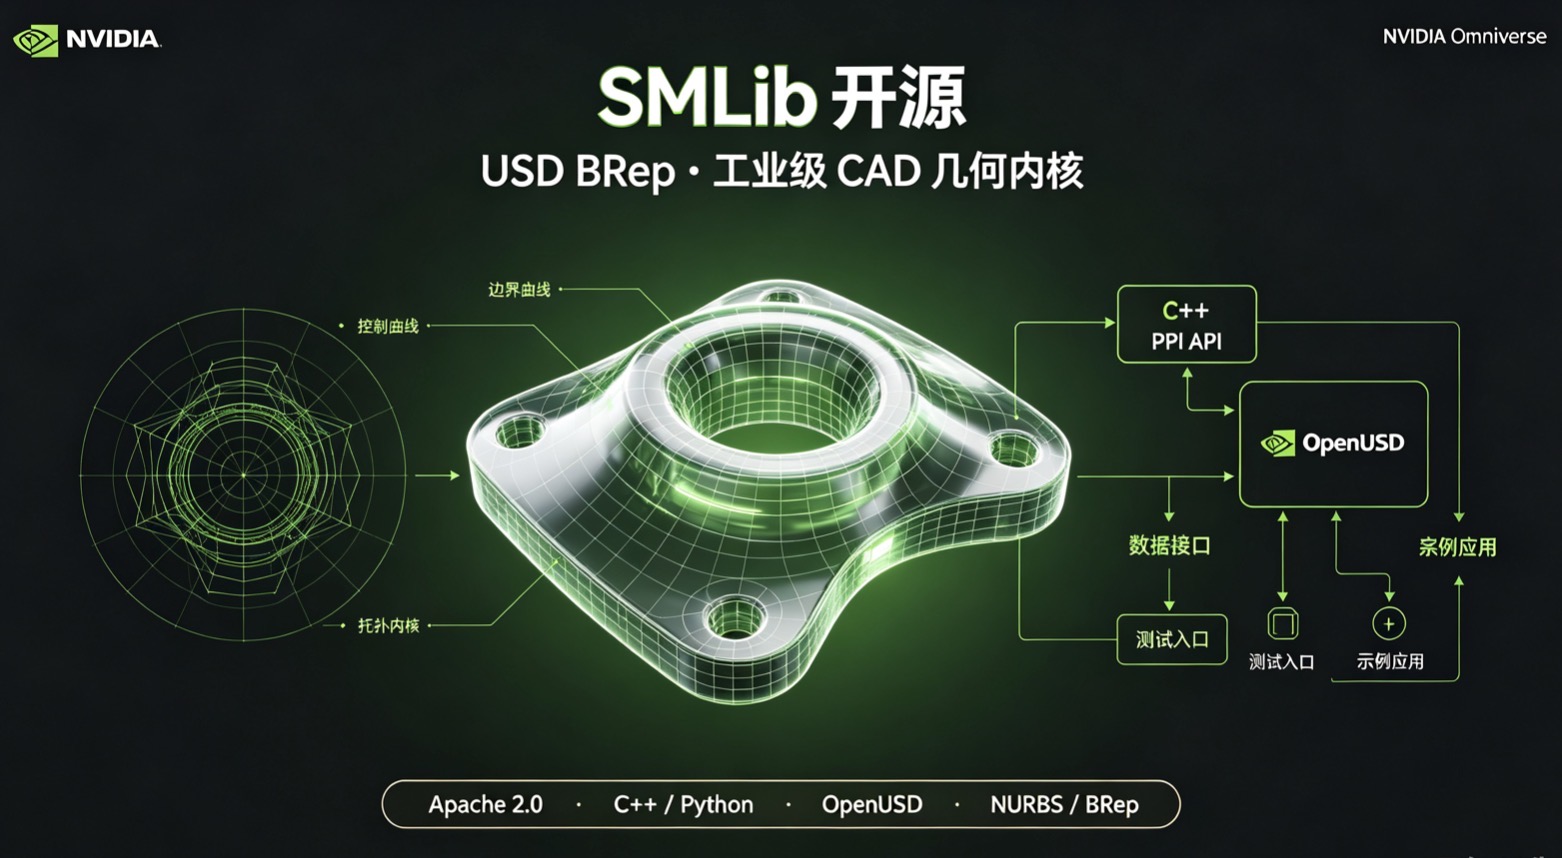
未来打通3D视觉表现和结构设计,可实现真正的高精可视化工业数字孪生。
4 个月前
西门子Xcelerator开放式数字商业平台作为正式发布生态合作伙伴"繁星计划",旨在发挥平台网络效应,与生态伙伴共享知识与技术资源,共创面向客户的解决方案,共赢数字化与低碳化新机遇。

10 个月前
简要结论:物理AI(Physical AI)正在成为人工智能发展的新方向,它的现实性在于能否真正理解并遵循物理规律。目前已有测试框架和硬件架构推动落地,但仍存在显著差距,现实应用需要长期迭代。 什么是“物理AI” 定义:物理AI强调让人工智能不仅能生成文本或图像,还要能在现实世界中遵循物理定律,具备“具身智能”(Embodied AI)的能力。 目标:解决 AI 在仿真到现实(Sim-to-Real)转化中的落地难题,让机器人、自动驾驶、数字孪生等应用更可靠。 当前研究进展 PAI-Bench 测试框架:佐治亚理工学院与卡内基梅隆大学团队提出的标准,用于评估 AI 是否理解物理规律。测试包含 2808 个真实案例,涵盖自动驾驶预测、机器人操作等场景。结果显示:人类准确率约 93.2%,而最佳 AI 模型仅 64.7%。 英伟达“物理AI”战略:在 CES 2026 提出,基于 Vera Rubin 超算平台 + Omniverse 仿真环境 + Jetson T4000 边缘硬件,构建闭环架构,强调“不要只生成像素,要生成行动”。 ✅ 现实性分析 优势: 技术驱动:硬件(GPU、边缘计算)和仿真平台(Omniverse)已具备支撑条件。 应用需求强烈:自动驾驶、机器人、工业制造等都需要 AI 遵循物理规律。 研究路径明确:已有标准化测试框架(PAI-Bench),为模型改进提供方向。 局限: 理解不足:现有模型在物理推理上的表现远低于人类水平。 数据难题:物理规律涉及连续性和复杂交互,难以通过大规模数据直接学习。 落地成本高:需要强算力、精细仿真和高性能硬件,短期内难以普及。 ⚠️ 风险与挑战 幻觉问题:AI可能生成视觉效果逼真但违反物理规律的结果。 安全性:在自动驾驶或机器人场景中,错误的物理推理可能导致事故。 标准缺失:虽然有 PAI-Bench,但行业尚未形成统一的评估体系。 综合评价 物理AI的现实性在于“方向明确、路径清晰,但短期难以完全落地”。 它更像是未来十年 AI 的关键突破口:从“生成像素”走向“生成行动”。目前仍处于探索阶段,但随着硬件、仿真和测试框架的成熟,物理AI有望逐步应用于自动驾驶、机器人和工业场景。
10 个月前
YOLO(You Only Look Once),这确实是目前计算机视觉领域最热门、应用最广泛的目标检测算法之一。 简单来说,如果把计算机看作一个学生,传统的检测算法像是让学生“拿着放大镜,一点点扫描图片里有什么”,而 YOLO 则是让学生“一眼扫过整张图,立刻说出图里有什么、在哪儿”。 这种“一眼识别”的特性,让 YOLO 在速度和准确性上取得了极佳的平衡。结合掌握的资料,这里为你详细拆解一下 YOLO 的核心原理、发展历程以及它在现实中的应用。 ? YOLO 的核心工作原理:像人眼一样“扫视” YOLO 的核心思想是将目标检测问题转化为一个回归问题。它不需要像旧算法(如 R-CNN)那样先猜区域再识别,而是通过一次神经网络计算,直接从图像像素回归出物体的位置和类别。 我们可以把它的工作流程想象成老师给班级分组: 网格划分(Grid Cells): 算法会将输入的图像划分为 S times S 个小格子(例如 7x7)。如果一个物体的中心点落在某个格子里,那个格子就“负责”检测这个物体。 边界框预测(Bounding Boxes): 每个格子会预测出几个边界框(例如 2 个),每个框包含 5 个参数:中心坐标 (x, y)、宽 w、高 h 以及一个置信度(表示框里确实有物体的概率)。 类别概率(Class Probabilities): 同时,每个格子还会预测这个框内物体属于各个类别的概率(比如是猫的概率 80%,是狗的概率 5%)。 非极大值抑制(NMS): 因为多个格子可能会检测到同一个物体,最后会通过 NMS 算法“去重”,保留得分最高的框,去掉重叠度高且得分低的框。 ? 从 V1 到 V8:YOLO 的进化之路 YOLO 算法自 2015 年诞生以来,经历了多次重大的架构升级。为了让你更直观地了解,这里整理了主要版本的演进逻辑: YOLOv1: 首次提出“单阶段检测”概念,将检测视为回归问题。 开创性工作,速度快,但小目标检测精度一般。 YOLOv2/v3: 引入 Anchor Boxes(先验框)和多尺度预测。 检测精度大幅提升,尤其是小物体。v3 成为经典里程碑。 YOLOv4: 集成了大量优化技巧(CSPDarknet, PANet, Mosaic数据增强)。 在保持速度的同时,精度达到了当时的顶尖水平。 YOLOv5: 基于 PyTorch 实现,工程化极佳。 极易上手,提供了从小到大的多种模型(s/m/l/x),部署方便,工业界主流。 YOLOv8: 最新主流版本,进一步优化了架构和损失函数。 性能更强,支持分类、检测、分割等多种任务,是目前的首选之一。 ? 为什么 YOLO 如此受欢迎? ⚡ 极快的速度: 由于只需要“看一次”,YOLO 可以轻松达到实时处理(如 45 FPS 甚至更高),非常适合处理视频流。 ? 全局视野: 它在预测时利用了整张图的上下文信息,因此在背景中误检(把背景当作物体)的概率比两阶段算法要低。 ?️ 强大的泛化能力: 它学习到的特征具有很好的通用性,迁移到其他数据集上通常也能取得不错的效果。 ? 实际应用场景 基于 YOLO 的这些特性,它在很多领域都有广泛的应用: ? 智慧安防: 实时监控画面中的人体检测、异常行为识别。 ? 自动驾驶: 识别道路上的车辆、行人、交通标志,为车辆决策提供依据。 ? 工业质检: 在生产线上快速识别产品缺陷、零件缺失或错位。 ? 医疗影像: 辅助医生识别 X 光片或 CT 图像中的病变区域(如肿瘤)。 ? 物流分拣: 识别包裹上的条形码或分类标签。 ? 对初学者的建议 如果想入门或使用 YOLO 进行图像识别: 新手入门: 推荐从 YOLOv5 或 YOLOv8 开始。它们的官方文档非常完善,代码(通常是 PyTorch 版本)易于理解,且社区支持丰富。 数据准备: 图像识别的效果很大程度上取决于数据。你需要准备标注好的数据集(通常标注工具会生成 .txt 或 .xml 文件,标明物体的类别和坐标)。 硬件要求: 虽然 YOLO 很快,但训练过程通常还是需要 GPU(如 NVIDIA 显卡)来加速。
11 个月前
MuJoCo+机器学习的核心是用MuJoCo做高精度物理仿真环境,搭配强化学习(RL)、模仿学习(IL)、最优控制等算法,快速训练机器人/智能体策略,实现高效迭代与sim-to-real迁移 。以下是关键清单与实操要点。 一、核心组件与安装 核心库:MuJoCo本体(C/C++引擎)、mujoco-py(Python绑定)、MJX(JAX原生,GPU/TPU并行,强化学习首选) 依赖框架:Gymnasium/MuJoCo Gym(标准环境)、JAX/PyTorch/TensorFlow(算法训练)、Robosuite/Robomimic(机械臂IL) 安装步骤: 1. 安装MuJoCo(含许可证): pip install mujoco 2. 安装MJX(JAX生态): pip install mujoco 3. 环境库: pip install gymnasium robosuite robomimic 二、常用应用场景与算法 强化学习(主流):机械臂抓取/操作、四足/人形机器人运动、灵巧手控制;常用算法PPO、SAC、TD3、DQN,并行rollout提升效率 模仿学习:用BC、GAIL、AMP复现人类/专家演示,适合复杂操作;依赖Robosuite采集数据、Robomimic训练 最优控制:LQR/iLQR用于高精度轨迹跟踪,结合MuJoCo接触模型与可微分仿真,适合模型已知场景 三、快速上手流程(以PPO训练机械臂为例) 1. 定义MuJoCo模型:用XML描述机械臂(如Panda/UR5)、关节、接触参数与奖励函数 2. 封装Gym环境:继承 gym.Env ,实现 step() / reset() / render() ,输出状态/图像观测 3. 构建PPO策略:用PyTorch/JAX写Actor-Critic网络,设置学习率、折扣因子、clip参数 4. 并行训练:用MJX+JAX实现批量环境并行,GPU加速;训练10⁵-10⁶步,监控奖励与成功率 5. 评估与迁移:测试收敛策略,用领域随机化提升sim-to-real鲁棒性 四、关键优化与工具 性能:用MJX+JAX JIT实现上千环境并行,训练速度提升10–100倍 仿真精度:调 impratio (摩擦/穿透权衡)、软接触模型,减少仿真-现实差距 可视化:用MuJoCo原生渲染或 matplotlib /TensorBoard监控训练曲线与状态 数据集/基准:LocoMuJoCo(运动IL)、MuJoCo Playground(快速上手)、Robomimic Benchmark(操作) 五、避坑要点 奖励函数设计:稀疏奖励难收敛,用稠密奖励+ shaping(如距离惩罚、平滑动作) 接触不稳定性:降低 timestep 、启用soft contacts,避免刚体穿透 并行训练:MJX优先,避免mujoco-py多线程GIL瓶颈;图像观测用离线渲染加速 sim-to-real:添加质量/摩擦/噪声随机化,提升策略泛化性 六、入门项目推荐 1. 基础:MuJoCo Gym的 Hopper-v4 (PPO训练) 2. 进阶:Robosuite+PPO实现机械臂抓取,用RGB-D图像观测 3. 高阶:MJX+LocoMuJoCo训练四足机器人,实现跑跳与摔倒恢复

1 年前
恒图科技是一家专注于数字创意视觉内容创作与人工智能技术融合的文化科技型企业。恒图科技(成都恒图科技有限责任公司)在数字视觉内容创作和人工智能领域具有全球影响力,尤其以其核心产品Fotor而闻名。 这里是公司及业务概览: 类别 详细信息 公司名称 成都恒图科技有限责任公司 成立时间 2009年 创始人/CEO 段江 公司定位 专注于视觉内容创作与人工智能融合创新的科技型企业 核心产品 Fotor (图片处理与设计软件)、Clipfly (AI视频制作平台) 技术核心 HDR(高动态范围图像)技术、生成式人工智能(AIGC) 市场与用户 覆盖全球200多个国家和地区,用户量约7-8亿,绝大部分为海外用户 主要荣誉 2025年福布斯中国人工智能科技企业TOP50、德勤中国高科技高成长50强 ? 发展历程与核心优势 恒图科技的发展历程,是一部深耕技术、顺势而为的进化史。 技术奠基与出海:公司自成立起就专注于图像处理技术,尤其在HDR(高动态范围图像)技术领域拥有领先的核心专利。早期,团队就做出了一个关键决策:主攻海外市场,打造标准化的产品。其产品因操作简单、效果专业,迅速获得了海外用户的认可,BBC曾将Fotor誉为“Photoshop的后继者”。 拥抱AI浪潮:当生成式人工智能(AIGC)兴起时,恒图科技展现了强大的技术敏锐度和快速反应能力。他们在2022年10月就为Fotor上线了AI功能,并逐步将产品从单一的图片编辑,拓展为涵盖AI文生图、AI文生视频等超100种功能的一站式AI视觉内容创作平台。这不仅吸引了更多用户,也让他们成为国内为数不多在该领域实现规模化盈利的企业。 强大的技术合作:为了支撑全球海量用户的创作需求,恒图科技与火山引擎展开了深度合作。火山引擎为其提供了强大的AI算力保障,支撑了恒图超过80%的推理和训练任务。这一合作显著提升了其AI视频生成的能力与质量,帮助恒图实现了用户付费转化率提升23%、AI人均视频生成次数提升12%的亮眼成绩。 ?️ 主要产品与应用 恒图科技的产品矩阵紧密围绕“让创作更简单”这一核心目标展开。 Fotor:这是恒图科技的旗舰产品。它不仅仅是一个修图工具,更是一个覆盖网页端、移动端和桌面端的一体化设计平台。通过引入AI技术,Fotor极大地降低了专业设计的门槛,让没有任何设计背景的普通用户也能轻松制作海报、社交媒体图片等。 Clipfly:这是恒图科技推出的一站式AI视频制作平台。它集成了文生视频、图生视频、自动字幕、视频编辑等功能,让一个人、一台电脑就能快速完成具有电影质感的视频创作,极大地降低了视频创作的成本和门槛。该产品在文旅宣传、内容创作等领域有很好的应用前景。 ? 行业影响与未来前景 恒图科技的成功,不仅在于商业上的成就,更在于其带来的行业变革与文化价值。 推动创作“智能化”:恒图科技将自己定位为数字创意创作“智能化”的推动者。如果说Photoshop代表了“专业化”,Canva代表了“平民化”,那么Fotor的目标就是通过AI技术,将视觉内容创作带入“全民皆可为的智能化时代”。 架起文化出海桥梁:恒图科技的产品拥有庞大的海外用户群,这使其成为中国文化出海的一个独特渠道。通过Fotor、Clipfly等产品,中国传统的文化元素、IP可以以图像、视频等更易被接受的形式传播到全球,促进跨文化的交流与理解。 ( 图片来源:fotor.com.cn )