德国Comarch ERP Enterprise 是一款全面的企业资源规划 (ERP) 系统,专为寻求在流程方面提高 ERP 系统用户技术进步水平的企业而设计。它是一款现代化的 ERP 系统,具有高度的灵活性和可扩展性,能够满足各种规模和行业的企业的需求。
Comarch企业软件公司最近撰文:“ChatERP: Quantensprung im Enterprise-Resource-Planning”,即ChatERP在企业资源规划中的巨大进步。这份白皮书提到ERP系统是企业的核心,整合了关键业务流程和数据。过去,AI在ERP中的应用成本高且复杂,主要适用于大企业。但生成式AI和大型语言模型(如ChatGPT)的出现改变了这一状况,使得中小企业也能利用AI提升竞争力。这里的关键点是生成式AI降低了使用门槛,使得ERP中的AI助手变得可行。
1. 引言与背景
ERP系统的重要性:作为企业核心,整合关键业务流程(生产、采购、销售等)及数据(客户、订单、库存等)。AI在ERP中的演变:传统AI(如机器学习)成本高、数据需求大,仅适用于大企业;生成式AI(如ChatGPT)通过大型语言模型(LLM)降低门槛,使中小企业也能利用AI提升竞争力。ChatERP的定位:Comarch ERP Enterprise(6.4+版本)内置的多语言AI助手,通过自然语言交互革新ERP使用方式。
2. 改善可用性与降低使用障碍
自然语言交互:用户可通过对话形式与ERP系统互动,支持多语言,会话上下文感知。
动态帮助系统:基于RAG(检索增强生成)技术,AI助手深度理解ERP系统细节,无需额外训练。替代静态文档,提供实时、步骤化指导(如创建新文章、导航功能)。
降低学习成本:新用户快速上手,缩短培训时间;有经验用户更快掌握新功能。减少对IT支持的依赖,释放IT团队资源用于创新任务。
3. 通过语音/文本命令高效控制应用
多模态交互:支持传统UI操作与语音/文本指令结合,提升效率。应用场景:
快速导航:直接跳转深层功能(如“打开分类为家居用品的文章”)。数据操作:创建/打开记录(如“为Mustermann公司新建订单”并预填数据)。自动化任务:处理重复性工作(数据清理),但关键操作需人工审核。
类似消费级助手(如Siri):但针对企业复杂场景优化,通过API集成ERP功能。
4. 通过聊天探索ERP数据价值
数据查询与分析:
自然语言生成报告(如“显示上季度各地区销售额”),自动生成图表或摘要。预测与洞察:销售趋势预测、库存优化建议。
降低数据分析门槛:非技术用户无需复杂技能即可获取业务洞察,支持数据驱动决策。
5. 安全与合规
权限管理:通过架构设计确保数据访问合规性(如Berechtigungen权限控制)。数据隐私:企业数据仅用于内部处理,符合GDPR等法规。
6. 实施建议与结论
采用策略:
选择兼容现有系统的AI助手(如ChatERP),分阶段部署,从小任务开始。培训员工适应新交互方式,结合传统与AI操作以最大化效率。
未来潜力:
持续优化AI模型,扩展应用场景(如供应链优化、客户行为分析)。推动ERP从“记录系统”向“智能决策支持系统”转型。
核心价值总结:
ChatERP通过自然语言交互、动态帮助、语音控制及智能数据分析,显著提升ERP系统的易用性、效率和决策支持能力,尤其助力中小企业以更低成本实现数字化转型。

4 天前
Chief AI Officer(Chief Artificial Intelligence Officer),首席人工智能官。
8 天前
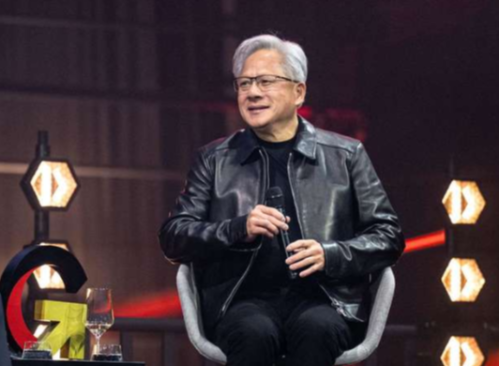
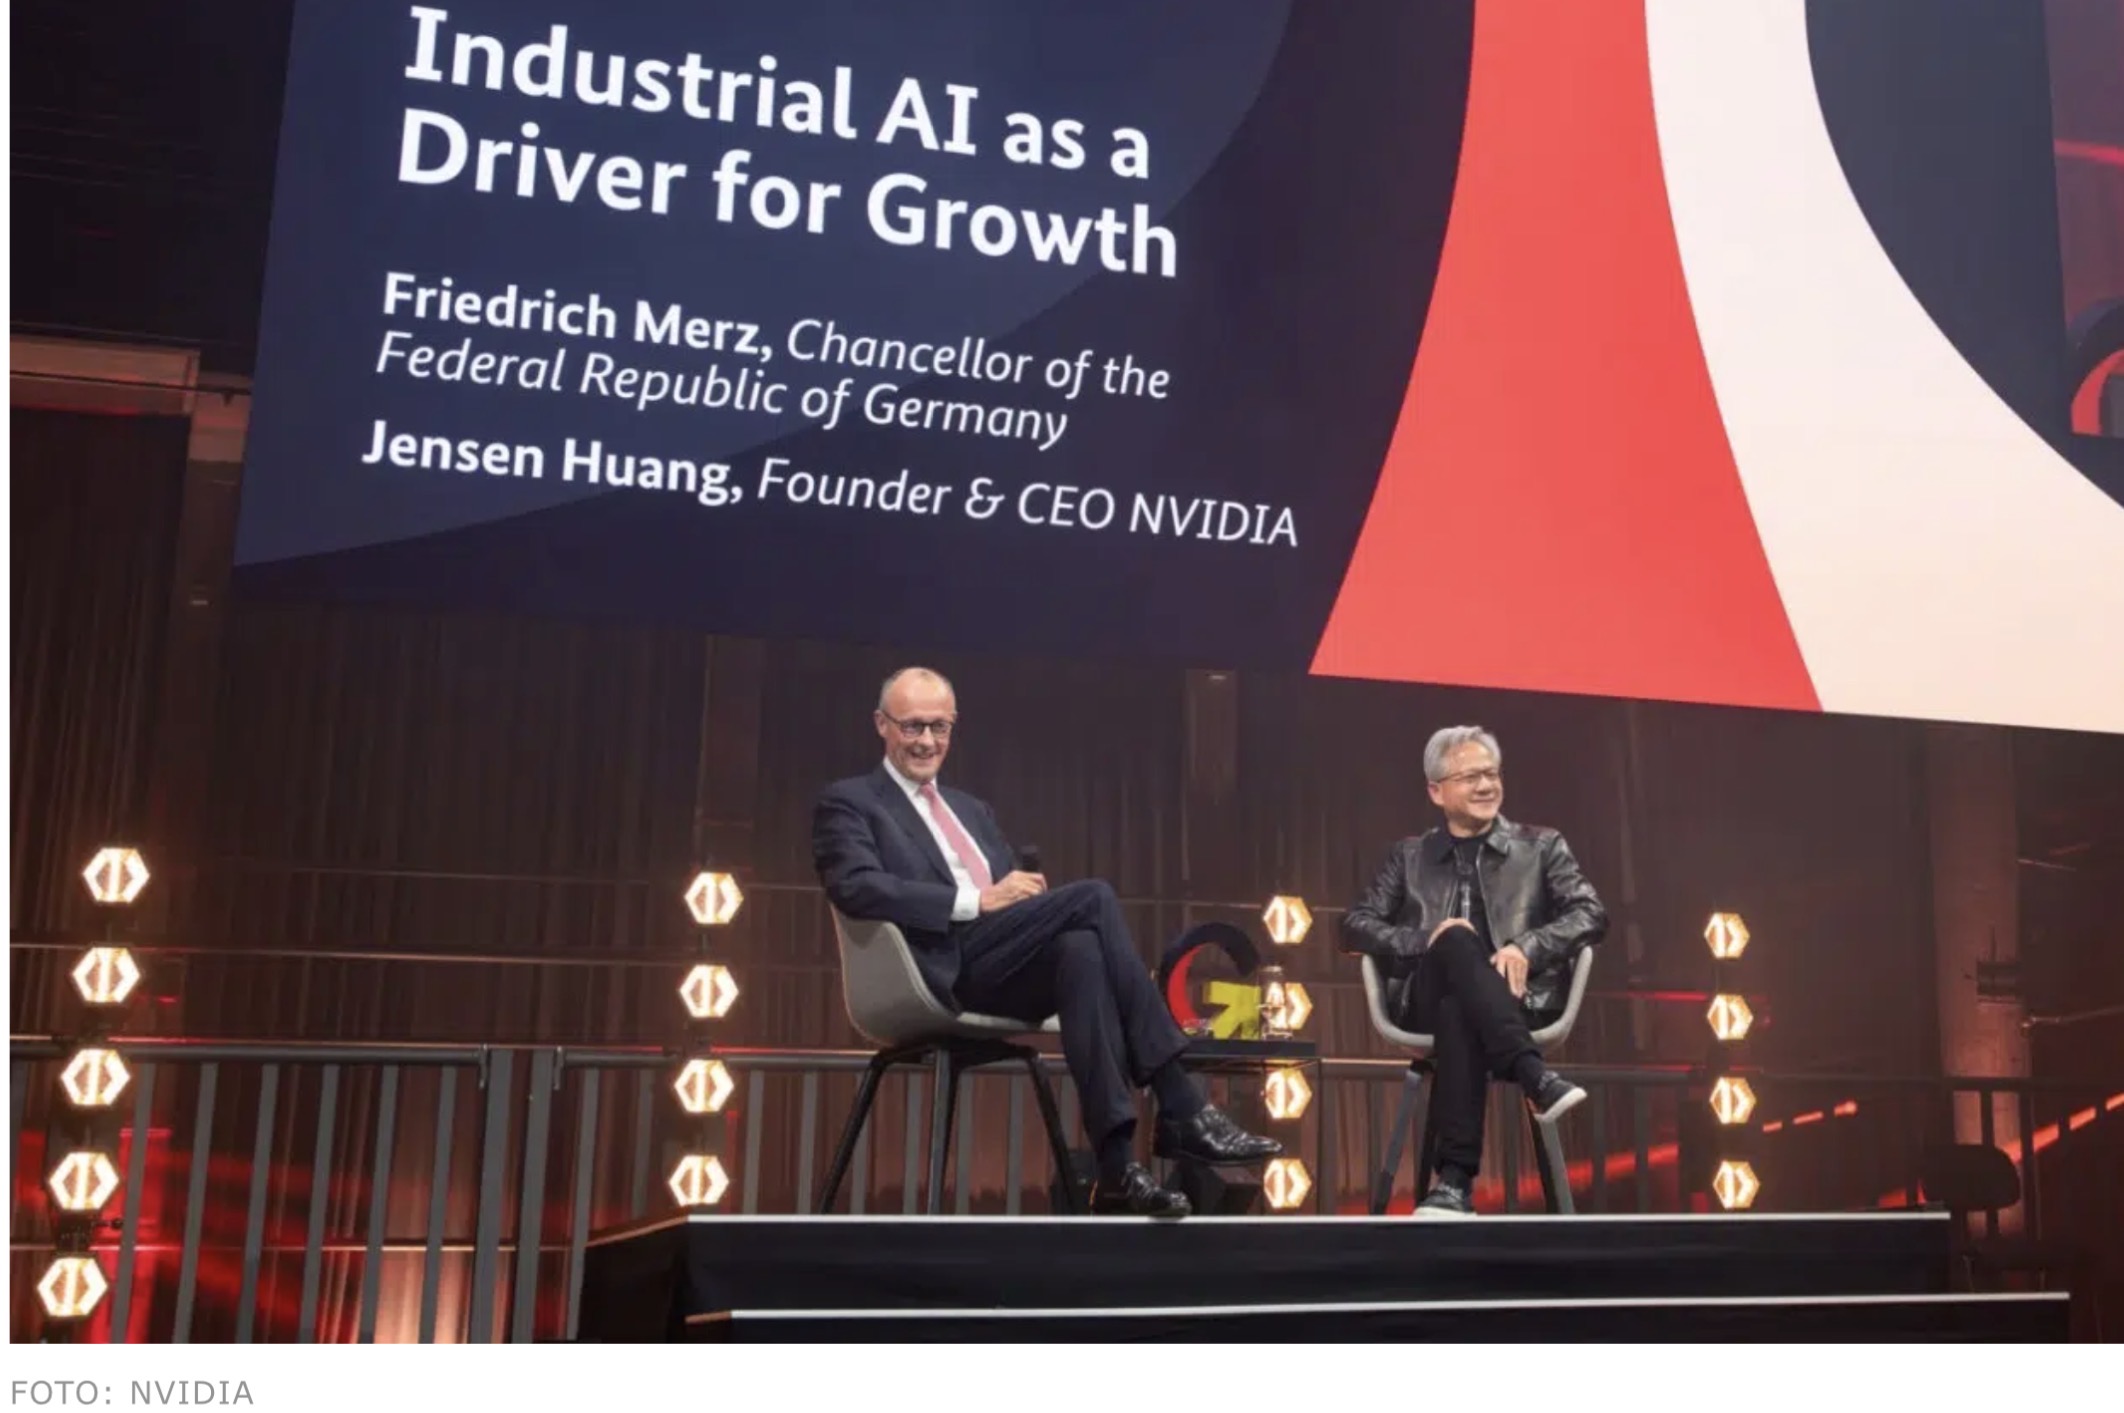
“如果技术不存在,就无从监管。” 黄仁勋进一步强调,如果AI产业无法蓬勃发展,“那就没什么可监管的了”。
9 天前
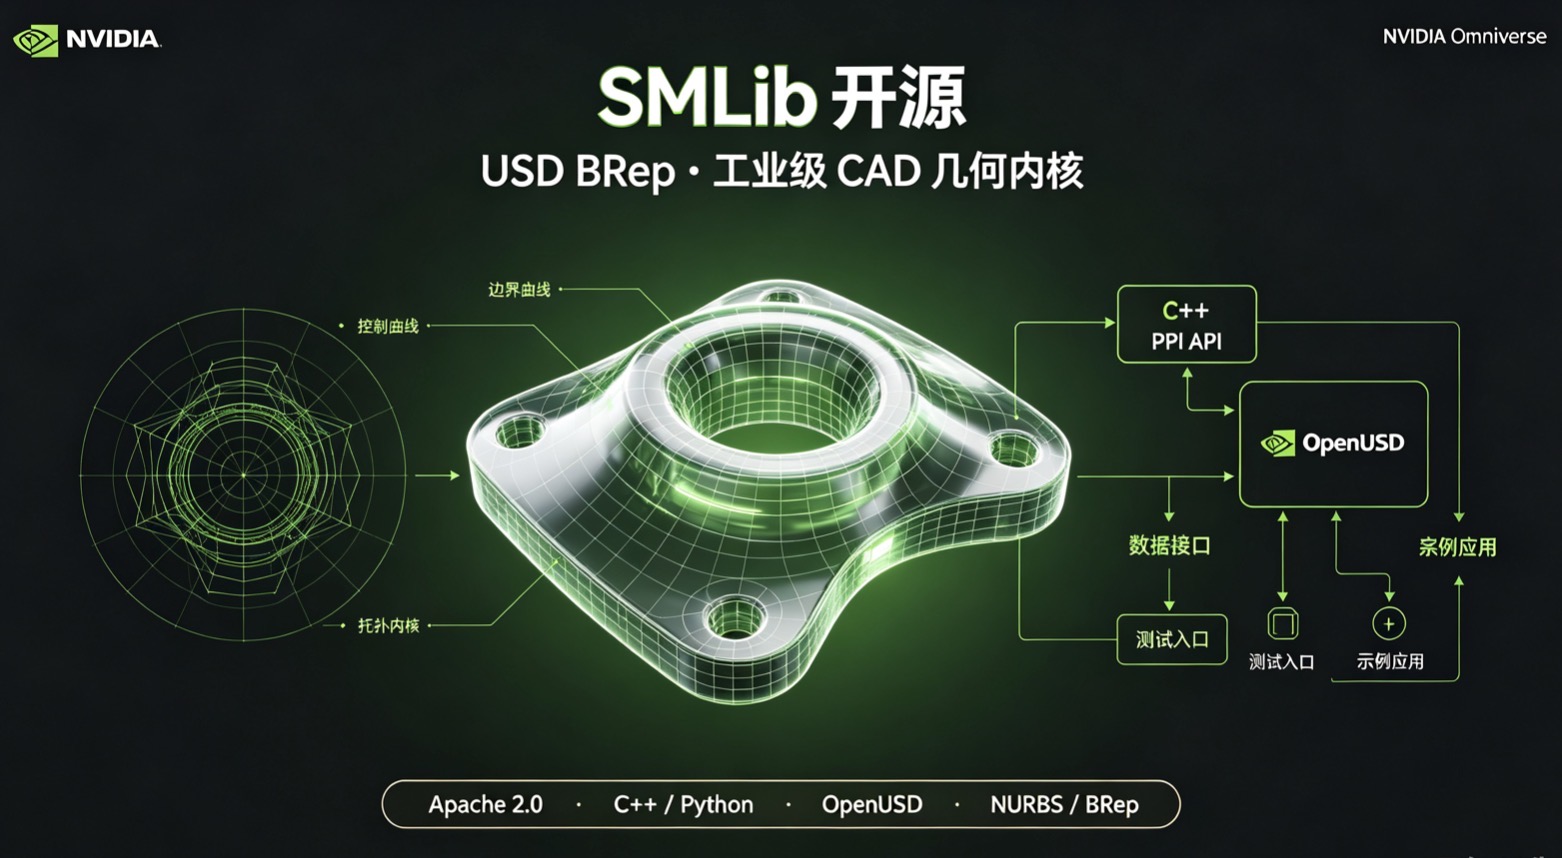
很多人以为 AI 时代的终局是“无人工厂”。黄仁勋在柏林给的版本,温柔得多,也更德国:电子不取代原子;它让原子被理解得更深。
13 天前
未来打通3D视觉表现和结构设计,可实现真正的高精可视化工业数字孪生。
2 个月前
Berlin BIG BANG KI Festival 是欧洲领先的人工智能商业创新盛会,汇聚全球 AI 企业、创业者、投资机构和行业领袖,共同探索人工智能的未来应用与商业价值。
3 个月前
西门子Xcelerator开放式数字商业平台作为正式发布生态合作伙伴"繁星计划",旨在发挥平台网络效应,与生态伙伴共享知识与技术资源,共创面向客户的解决方案,共赢数字化与低碳化新机遇。
9 个月前
简要结论:物理AI(Physical AI)正在成为人工智能发展的新方向,它的现实性在于能否真正理解并遵循物理规律。目前已有测试框架和硬件架构推动落地,但仍存在显著差距,现实应用需要长期迭代。 什么是“物理AI” 定义:物理AI强调让人工智能不仅能生成文本或图像,还要能在现实世界中遵循物理定律,具备“具身智能”(Embodied AI)的能力。 目标:解决 AI 在仿真到现实(Sim-to-Real)转化中的落地难题,让机器人、自动驾驶、数字孪生等应用更可靠。 当前研究进展 PAI-Bench 测试框架:佐治亚理工学院与卡内基梅隆大学团队提出的标准,用于评估 AI 是否理解物理规律。测试包含 2808 个真实案例,涵盖自动驾驶预测、机器人操作等场景。结果显示:人类准确率约 93.2%,而最佳 AI 模型仅 64.7%。 英伟达“物理AI”战略:在 CES 2026 提出,基于 Vera Rubin 超算平台 + Omniverse 仿真环境 + Jetson T4000 边缘硬件,构建闭环架构,强调“不要只生成像素,要生成行动”。 ✅ 现实性分析 优势: 技术驱动:硬件(GPU、边缘计算)和仿真平台(Omniverse)已具备支撑条件。 应用需求强烈:自动驾驶、机器人、工业制造等都需要 AI 遵循物理规律。 研究路径明确:已有标准化测试框架(PAI-Bench),为模型改进提供方向。 局限: 理解不足:现有模型在物理推理上的表现远低于人类水平。 数据难题:物理规律涉及连续性和复杂交互,难以通过大规模数据直接学习。 落地成本高:需要强算力、精细仿真和高性能硬件,短期内难以普及。 ⚠️ 风险与挑战 幻觉问题:AI可能生成视觉效果逼真但违反物理规律的结果。 安全性:在自动驾驶或机器人场景中,错误的物理推理可能导致事故。 标准缺失:虽然有 PAI-Bench,但行业尚未形成统一的评估体系。 综合评价 物理AI的现实性在于“方向明确、路径清晰,但短期难以完全落地”。 它更像是未来十年 AI 的关键突破口:从“生成像素”走向“生成行动”。目前仍处于探索阶段,但随着硬件、仿真和测试框架的成熟,物理AI有望逐步应用于自动驾驶、机器人和工业场景。
10 个月前
YOLO(You Only Look Once),这确实是目前计算机视觉领域最热门、应用最广泛的目标检测算法之一。 简单来说,如果把计算机看作一个学生,传统的检测算法像是让学生“拿着放大镜,一点点扫描图片里有什么”,而 YOLO 则是让学生“一眼扫过整张图,立刻说出图里有什么、在哪儿”。 这种“一眼识别”的特性,让 YOLO 在速度和准确性上取得了极佳的平衡。结合掌握的资料,这里为你详细拆解一下 YOLO 的核心原理、发展历程以及它在现实中的应用。 ? YOLO 的核心工作原理:像人眼一样“扫视” YOLO 的核心思想是将目标检测问题转化为一个回归问题。它不需要像旧算法(如 R-CNN)那样先猜区域再识别,而是通过一次神经网络计算,直接从图像像素回归出物体的位置和类别。 我们可以把它的工作流程想象成老师给班级分组: 网格划分(Grid Cells): 算法会将输入的图像划分为 S times S 个小格子(例如 7x7)。如果一个物体的中心点落在某个格子里,那个格子就“负责”检测这个物体。 边界框预测(Bounding Boxes): 每个格子会预测出几个边界框(例如 2 个),每个框包含 5 个参数:中心坐标 (x, y)、宽 w、高 h 以及一个置信度(表示框里确实有物体的概率)。 类别概率(Class Probabilities): 同时,每个格子还会预测这个框内物体属于各个类别的概率(比如是猫的概率 80%,是狗的概率 5%)。 非极大值抑制(NMS): 因为多个格子可能会检测到同一个物体,最后会通过 NMS 算法“去重”,保留得分最高的框,去掉重叠度高且得分低的框。 ? 从 V1 到 V8:YOLO 的进化之路 YOLO 算法自 2015 年诞生以来,经历了多次重大的架构升级。为了让你更直观地了解,这里整理了主要版本的演进逻辑: YOLOv1: 首次提出“单阶段检测”概念,将检测视为回归问题。 开创性工作,速度快,但小目标检测精度一般。 YOLOv2/v3: 引入 Anchor Boxes(先验框)和多尺度预测。 检测精度大幅提升,尤其是小物体。v3 成为经典里程碑。 YOLOv4: 集成了大量优化技巧(CSPDarknet, PANet, Mosaic数据增强)。 在保持速度的同时,精度达到了当时的顶尖水平。 YOLOv5: 基于 PyTorch 实现,工程化极佳。 极易上手,提供了从小到大的多种模型(s/m/l/x),部署方便,工业界主流。 YOLOv8: 最新主流版本,进一步优化了架构和损失函数。 性能更强,支持分类、检测、分割等多种任务,是目前的首选之一。 ? 为什么 YOLO 如此受欢迎? ⚡ 极快的速度: 由于只需要“看一次”,YOLO 可以轻松达到实时处理(如 45 FPS 甚至更高),非常适合处理视频流。 ? 全局视野: 它在预测时利用了整张图的上下文信息,因此在背景中误检(把背景当作物体)的概率比两阶段算法要低。 ?️ 强大的泛化能力: 它学习到的特征具有很好的通用性,迁移到其他数据集上通常也能取得不错的效果。 ? 实际应用场景 基于 YOLO 的这些特性,它在很多领域都有广泛的应用: ? 智慧安防: 实时监控画面中的人体检测、异常行为识别。 ? 自动驾驶: 识别道路上的车辆、行人、交通标志,为车辆决策提供依据。 ? 工业质检: 在生产线上快速识别产品缺陷、零件缺失或错位。 ? 医疗影像: 辅助医生识别 X 光片或 CT 图像中的病变区域(如肿瘤)。 ? 物流分拣: 识别包裹上的条形码或分类标签。 ? 对初学者的建议 如果想入门或使用 YOLO 进行图像识别: 新手入门: 推荐从 YOLOv5 或 YOLOv8 开始。它们的官方文档非常完善,代码(通常是 PyTorch 版本)易于理解,且社区支持丰富。 数据准备: 图像识别的效果很大程度上取决于数据。你需要准备标注好的数据集(通常标注工具会生成 .txt 或 .xml 文件,标明物体的类别和坐标)。 硬件要求: 虽然 YOLO 很快,但训练过程通常还是需要 GPU(如 NVIDIA 显卡)来加速。