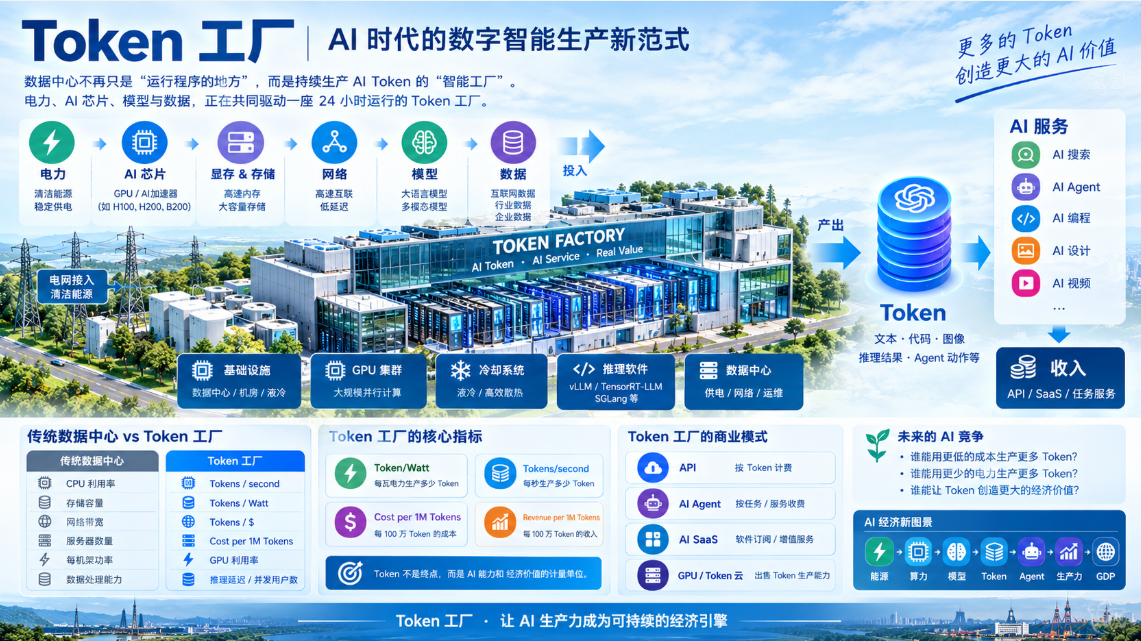
Token 工厂,词元工厂,是生成式人工智能时代正在形成的一种新型基础设施概念:数据中心不再只是“运行程序的地方”,而成为持续生产 AI Token 的“智能工厂”。
简单来说:
电力 + GPU/AI芯片 + 模型 + 数据 + 推理软件 → Token → AI服务 → 收入
NVIDIA 已明确使用“AI Token Factory(AI Token 工厂)”来描述这一趋势,并把 Token 产量、每瓦 Token 数量、每美元 Token 数量以及每个 Token 的成本作为衡量 AI 基础设施经济性的核心指标。(NVIDIA)
Token 是大语言模型处理信息的基本单位。
例如一句话:
“人工智能正在改变工业生产。”
进入模型以后,并不是以完整汉字句子的形式直接计算,而是会被拆分成模型能够处理的 Token。
因此,AI模型的工作过程可以粗略理解为:
用户输入 → Token化 → GPU计算 → 输出Token → 重新组合成文字/代码/答案
所以,ChatGPT、AI搜索、AI Agent、AI编程、AI视频生成等服务,本质上都在消耗和产生大量 Token。
传统工厂:
原材料 → 机器 → 产品
AI工厂:
电力 → AI芯片 → 模型推理 → Token
传统制造业生产汽车、冰箱、手机。
而 AI 基础设施生产的是:
文本、代码、推理结果、决策、图像、Agent动作等数字智能。
其中,在大型语言模型时代,Token 可以被看作衡量这种“数字智能产量”的一个基础计量单位。
因此,可以把一个大规模 AI 数据中心理解成:
一座 24 小时运行的“智能生产工厂”。
NVIDIA 对这一概念的描述就是:数据中心正在从传统的数据处理设施转变为生产 Token 的 AI Token Factory。(NVIDIA)
可以把 Token 工厂理解成五层结构:
                 用户需求
                    ↓
             AI Application
                    ↓
        ┌────────────────────┐
        │   AI Model / LLM   │
        └────────────────────┘
                    ↓
          Inference 推理系统
                    ↓
        ┌────────────────────┐
        │ GPU / AI Accelerator│
        └────────────────────┘
                    ↓
          电力 + 数据中心 + 网络
                    ↓
              Token Output
                    ↓
          AI服务 / API / Agent
                    ↓
                 收入
真正重要的是最后这一点:
Token 不只是技术指标,它正在成为 AI 基础设施的经济计量单位。
传统数据中心关注:
Token 工厂则更加关注:
也就是说,衡量标准正在从:
“我有多少计算能力?”
转向:
“我的计算基础设施到底生产了多少智能?”
这也是为什么单纯比较 GPU 的 FLOPS 已经不能完整反映 AI 推理经济性。实际 Token 产量还受到显存、内存带宽、批处理、模型结构、推理软件以及负载情况影响。(NVIDIA Blog)
可以简单理解:
Token/Watt = 每消耗1瓦电能够生产多少Token
这意味着未来 AI 数据中心的竞争,不一定只是:
谁拥有更多 GPU。
而可能越来越变成:
谁能够用同样的电力生产更多 Token。
例如:
数据中心A
100 MW
↓
1000亿 Token/小时

数据中心B
100 MW
↓
2000亿 Token/小时
虽然两座数据中心使用同样的电力,但 B 的“Token生产能力”是 A 的两倍。
因此:
电力效率 → Token效率 → AI服务成本 → 商业竞争力
NVIDIA 目前也将“tokens per watt”作为 AI 推理基础设施经济性的重要指标。(NVIDIA Perspectives)
这是理解 Token 工厂非常重要的一点。
很多人会简单认为:
GPU越多 = Token越多 = 收入越高。
实际上并不完全如此。
一座 Token 工厂至少包括:
例如:
大型模型推理需要大量高速存储。
尤其是大型模型和 MoE 模型,需要高速 GPU 间通信。
例如:
软件优化可以显著影响实际 Token 产量。NVIDIA 公开资料显示,其 TensorRT-LLM 等软件优化可以大幅降低特定工作负载的单位 Token 成本;不过这些数据属于厂商披露的特定测试结果,不应直接视为所有模型和环境的普遍结果。(NVIDIA Perspectives)
AI工厂最重要的“原材料”之一。
GPU产生大量热量,需要液冷或其他高效冷却系统。
同样的硬件运行不同模型,Token产量可能完全不同。
这是理解这一概念最重要的一层。
Token 本身没有多少价值。
例如:
生成1万个没有用的Token,价值可能接近于零。
但如果这些 Token:
那么 Token 就产生了真正的经济价值。
所以更完整的关系应该是:
Token → AI能力 → 工作 → 经济价值
因此未来的 AI 经济学不能只研究:
Token多少钱?
还要研究:
一个Token创造了多少价值?
这也是目前“AI Tokenomics(AI Token经济学)”正在讨论的问题。相关框架已经开始从 Token 的供给、需求、效用和货币化四个方面研究 AI 的经济模型。(NVIDIA)
Token 工厂可以通过多种方式赚钱。
企业购买:
100万 Token
1000万 Token
10亿 Token
例如:
Token Factory
      ↓
LLM API
      ↓
企业客户
      ↓
按Token计费客户不是购买 Token,而是购买:
完成任务
例如:
“帮我分析1000份德国工程标准。”
背后可能消耗数百万 Token。
客户支付的是任务服务费,而 Token 是后台生产成本。
例如:
用户购买的是软件服务,而不是 Token。
传统云计算:
GPU小时 → 收费
Token Cloud:
Token → 收费
这意味着 GPU 云正在从:
出租计算资源
逐渐向:
出售 AI 生产能力
转变。部分云基础设施服务商已经开始直接使用“Token Factory”来描述这种商业模式。(solvimon.com)
可以建立一个非常简单的模型:
Token产量 = GPU数量 × 单GPU有效Token吞吐量 × 利用率
进一步:
Token成本 = 总基础设施成本 ÷ Token总产量
总成本包括:
所以真正重要的指标是:
Cost / 1 Million Tokens
以及:
Revenue / 1 Million Tokens
最终:
Token毛利 = Token收入 − Token生产成本
如果这个趋势继续发展,未来可能形成一套类似工业经济的体系:
| 工业时代 | AI时代 |
|---|---|
| 石油 | 电力/算力资源 |
| 工厂 | AI数据中心 |
| 机器 | GPU/AI芯片 |
| 工人 | AI Agent |
| 产品 | Token/AI结果 |
| 生产效率 | Token/Watt |
| 单位成本 | Cost/Token |
| 工厂产能 | Token/Second |
| 商品 | AI能力 |
| 工业经济 | Token经济 |
因此,Token Factory 不只是一个数据中心概念,也可能成为理解 AI 经济的重要分析框架。
未来一个非常值得研究的问题是:
AI最大的瓶颈究竟是芯片,还是电力?
如果 AI 推理规模持续扩大,那么数据中心需要:
更多 GPU → 更多电力 → 更多散热 → 更多数据中心容量
因此,“每瓦生产多少 Token”越来越重要。
甚至可以把 AI 工厂的生产函数简化成:
AI产能 ≈ 电力 × Token/Watt
这意味着:
电力可能逐渐成为 AI 产业的“能源原材料”。
一些研究甚至开始从能源消耗、并发度、模型结构等维度重新计算单 Token 的真实能源成本。(arXiv)
过去几年大家讨论最多的是:
算力经济
核心指标是:
GPU数量、FLOPS、算力规模。
但进入 AI Agent 和大规模推理时代以后,可能出现一个新的经济计量体系:
Token经济
核心指标变成:
Token数量、Token成本、Token效率、Token价值。
也就是说:
芯片 → 算力
算力 → 模型
模型 → Token
Token → AI Agent
AI Agent → 经济产出
最终可能形成:
能源 → 算力 → 模型 → Token → Agent → 生产力 → GDP
这可能是研究 AI 经济学非常有价值的一条链条。
未来的大型 AI 数据中心可能越来越像工业革命时期的大型工厂。
例如:
        电网
         ↓
      电力能源
         ↓
   ┌───────────┐
   │ Token工厂 │
   │           │
   │ GPU       │
   │ AI模型    │
   │ 推理系统  │
   │ 数据      │
   └───────────┘
         ↓
     Token产能
         ↓
 ┌───────┼────────┐
 ↓       ↓        ↓
AI搜索  AI Agent  AI工业
 ↓       ↓        ↓
广告     软件      制造业
收入     收入      生产力
因此,未来衡量一个国家 AI 能力,可能不能只看:
有多少 AI 公司?
还需要考虑:
拥有多少 Token 生产能力?
如果进一步把 Token 经济学发展下去,可以提出一个非常有意思的研究方向:
即:
一个国家、地区或者企业在一定时期内生产、消费并创造经济价值的 AI Token 总量。
当然,Token数量本身不能直接等同于GDP,因为不同Token的质量、模型、任务和经济价值差异巨大。
因此更合理的研究方向可能是:
Token数量 × Token质量 × 任务价值 × 经济产出
由此进一步研究:
这些问题,可能构成未来 “Token Economics / Token经济学” 的重要研究领域。
Token 工厂,是理解 AI 基础设施经济学的一个非常有用的新概念。
它把过去看起来分散的几个东西连接起来:
芯片 → 数据中心 → 电力 → 模型 → 推理 → Token → AI服务 → 收入
过去我们问:
“这家公司有多少 GPU?”
未来可能更应该问:
“这座 AI 工厂每秒能够生产多少 Token?每兆瓦能够生产多少 Token?每个 Token 的成本是多少?这些 Token 又能够创造多少经济价值?”
这意味着 AI 的竞争正在从单纯的模型竞争,逐渐扩展到:
算力效率竞争 → Token生产效率竞争 → AI生产力竞争。
而这也使 “Token 工厂” 有可能成为继“数据中心”“算力中心”“AI工厂”之后,理解下一阶段 AI 产业结构的重要概念。(theregister)
一句话定义:
Token 工厂,就是以电力、AI芯片和模型为生产要素,以 Token 为标准化产出,以 AI 服务和经济价值为最终产品的新型数字智能基础设施。

1 年前
在自然语言处理和人工智能领域,token通常是指文本中的基本单元,比如一个单词、一个标点符号或者一个子词等。100万token的输入输出量是一个较大的数据规模,以下从不同角度来理解这一概念: 从文本长度角度 一般来说,英文中一个单词可以看作一个token,中文可能一个字或一个词作为一个token。如果平均每个token对应5个字符(这只是一个粗略的估计,实际会因语言、文本类型等因素而不同),那么100万token大约对应500万个字符。以一本普通的中文书籍每页约1000字来算,500万个字符相当于5000页的书籍内容,这是非常庞大的文本量。 从处理难度角度 对于语言模型等人工智能系统来说,处理100万token的输入输出意味着要处理大量的信息。模型需要在这么多的token中理解语义、语法关系,捕捉上下文信息等,这对模型的容量、计算能力和算法设计都提出了很高的要求。模型需要有足够多的参数和足够深的网络结构,才能有效地处理如此大规模的文本数据,以生成准确、合理的输出。 处理如此大量的token还需要消耗大量的计算资源和时间。在训练过程中,可能需要使用高性能的GPU或TPU集群,花费数天甚至数周的时间才能完成训练。在推理阶段,也需要较多的计算资源来快速处理输入并生成输出,以满足实时性或高效性的要求。 从应用场景角度 机器翻译:如果用于机器翻译任务,100万token可能包含了各种领域的大量句子和段落。这意味着模型可以学习到丰富的语言表达方式和翻译模式,能够处理更复杂、更专业的翻译任务,提高翻译的准确性和质量。 文本生成:在文本生成任务中,如创作小说、新闻报道等,100万token的输入可以让模型学习到大量的文本风格、主题和结构信息,从而生成更丰富多样、更具创意和逻辑性的文本内容。 智能客服:对于智能客服系统,100万token的输入输出量可以使系统处理大量的用户咨询和问题,学习到各种常见问题的回答模式和解决方案,从而更准确、更快速地为用户提供服务,提高用户满意度。

1 年前
Aleph Alpha无分词器LLM架构创新与应用解析 1️⃣ 创新架构:突破传统分词限制 德国Aleph Alpha公司推出无分词器(tokenizer-free)LLM架构,通过分层字符-词语处理机制解决传统模型痛点: 技术原理:采用轻量级字符编码器将字符序列直接转化为词嵌入,经主干模型处理后由紧凑解码器还原为字符,避免传统分词对低频语言及专业术语的割裂。 核心优势:支持多字母系统(如西里尔文、特殊符号)、小语种及垂直领域知识(法律/医疗术语),训练数据与计算需求降低70%,显著减少碳排放。 2️⃣ 技术联盟:优化生态与可持续性 联合AMD、SiloAI及Schwarz Digits构建技术生态: AMD提供硬件支持:通过优化芯片架构与云资源提升算力效率; SiloAI协同算法开发:压缩模型规模并加速推理过程; 商业场景验证:Lidl母公司数字部门推动零售等行业的本地化应用测试。 3️⃣ 欧洲中心战略:深耕专业与政务市场 聚焦欧洲多语言与合规需求,推出两大方向: 政府智能化:开发专用AI操作系统"Pharia",强化公共数据安全与多语言服务能力; 垂直领域渗透:针对金融、医疗等专业场景提供低能耗、高精度模型,规避依赖GPT系列的数据出境风险。 意义:该架构通过技术底层革新,降低LLM进入门槛,推动欧洲本土AI生态独立发展,同时以环保效益回应全球可持续计算趋势。
1 年前
在语言大模型中,字节(Byte)、字符(Character)和Token是三个不同的概念,它们在文本处理中扮演着不同的角色。以下是它们的详细区别: 1. 字节(Byte) 定义:字节是计算机存储和传输数据的基本单位,通常由8位二进制数组成,可以表示256种不同的值。 用途:字节用于存储和传输文本、图像、音频等数据。在文本处理中,字节用于表示字符的编码。 编码:不同的字符编码标准(如ASCII、UTF-8、UTF-16)使用不同数量的字节来表示字符。例如,ASCII编码中,一个字符通常占用1个字节,而在UTF-8编码中,一个字符可能占用1到4个字节。 2. 字符(Character) 定义:字符是文本的基本单位,可以是字母、数字、标点符号、空格等。字符是人类可读的文本元素。 用途:字符用于表示和显示文本内容。在文本处理中,字符是语言模型处理的基本单位之一。 编码:字符在计算机中通过编码标准(如Unicode)表示。不同的编码标准决定了字符如何映射到字节序列。例如,字符“A”在ASCII编码中表示为65(一个字节),而在UTF-8编码中也表示为65(一个字节)。 3. Token 定义:Token是语言模型处理文本时的基本单位,通常由模型的分词器(Tokenizer)将文本分割成更小的单元。Token可以是单个字符、单词、子词(subword)或符号。 用途:Token用于语言模型的输入和输出。模型通过处理Token序列来理解和生成文本。Token化是语言模型预处理文本的关键步骤。 分词:不同的语言模型使用不同的分词策略。例如,BERT模型使用WordPiece分词器,GPT模型使用Byte Pair Encoding(BPE)分词器。这些分词器将文本分割成适合模型处理的Token序列。 区别总结 字节:计算机存储和传输的基本单位,用于表示字符的编码。 字符:文本的基本单位,人类可读的文本元素。 Token:语言模型处理文本时的基本单位,由分词器将文本分割成适合模型处理的单元。 示例 假设有以下文本:“Hello, 世界!” 字节:在UTF-8编码中,“Hello, 世界!”可能表示为48 65 6C 6C 6F 2C 20 E4 B8 96 E7 95 8C 21(每个字符占用1到3个字节)。 字符:文本中的字符为“H”, “e”, “l”, “l”, “o”, “,”, “ ”, “世”, “界”, “!”。 Token:使用BERT的WordPiece分词器,Token可能为。 通过理解字节、字符和Token的区别,可以更好地理解语言模型如何处理和生成文本。
2 年前
要根据任务需求调整 token 的数量,可以考虑以下几个方面: 1. 明确任务目标和范围:首先要清晰地确定任务的具体内容和所需涵盖的信息范围。如果任务较为简单、明确,可能需要的 token 数量相对较少;若任务复杂、涉及多个方面和细节,就可能需要更多的 token 。 2. 分析输入和输出的复杂度:考虑输入数据的复杂程度和预期输出的详细程度。例如,对于简短的问答任务,输入简短,回答也相对简洁,所需 token 较少;而对于长篇的文本生成任务,如文章写作,就需要更多的 token 来表达丰富的内容。 3. 考虑模型的能力和性能:不同的语言模型对 token 数量的处理能力不同。一些模型在处理大量 token 时可能表现更好,但也可能存在性能下降或计算成本增加的情况。了解所使用模型的特点和限制,有助于合理调整 token 数量。 4. 进行试验和优化:通过多次试验不同的 token 数量设置,观察模型的输出质量和效率。根据试验结果逐步优化 token 数量,找到最适合当前任务的平衡点。 5. 参考类似任务的经验:如果有类似任务的处理经验,可以参考其 token 数量的设置,并根据当前任务的特殊需求进行适当调整。 总之,调整 token 数量需要综合考虑任务的性质、模型的能力以及实际的效果,通过不断尝试和优化来找到最合适的设置。 来源:豆包AI
2 年前
在 AI 语言模型中,Token 的大小并不是固定的字节数。 一般而言,一个简单的英文单词可能算作一个 Token,一个汉字有时也会被当作一个 Token。但像一些常见的短语、专有名词等可能会被视为一个 Token。 大致来说,1000 Token 可能包含几百个单词,或者几百个汉字,具体数量会因语言的复杂性、文本的内容等因素而有所不同。 例如,一段比较简洁明了、没有复杂表述的英文文本,1000 Token 可能包含约 700 - 800 个单词;而对于内容较为丰富、包含较多专业术语或复杂句式的文本,1000 Token 所包含的单词数量可能会更少。 对于中文,由于汉字的信息量相对较大,1000 Token 大约能涵盖 600 - 700 个汉字左右的文本量,但同样会受到文本特点的影响。
2 年前
在调用大模型时,输入价格和输出价格是指在使用大模型进行文本生成或其他任务时,对于输入文本和输出文本所收取的费用。
2 年前
在自然语言处理(NLP)中,token是指文本中最小的语义单元。比如,一个句子可以被分割成若干个单词,每个单词就是一个token。
1 个月前
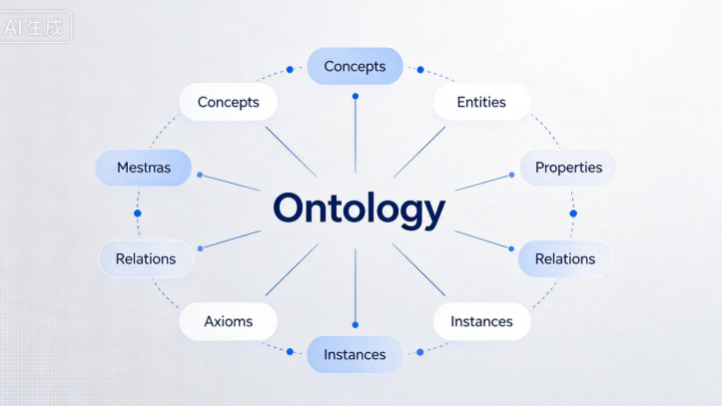
AI领域的Ontology(本体)是对领域概念、属性、相互关系进行显式、规范化定义的语义模型,提供知识的逻辑骨架,让机器可以理解、推理领域知识。