
在大模型(如深度学习模型)中,微调(Fine-Tuning)是指在预训练模型的基础上,对模型进行进一步的训练,以适应特定任务或数据集的需求。预训练模型通常是在大规模数据集上训练的,具有很好的泛化能力,但可能不完全适合特定的任务或数据集。微调的目的是通过对预训练模型进行少量的调整,使其更好地适应特定的任务或数据集。
微调通常包括以下步骤:
微调的好处包括:
常见的微调方法包括:
总之,微调是大模型中一个重要的技术,用于提高模型的适应性和准确性。
来源:HuggingChat
1 个月前
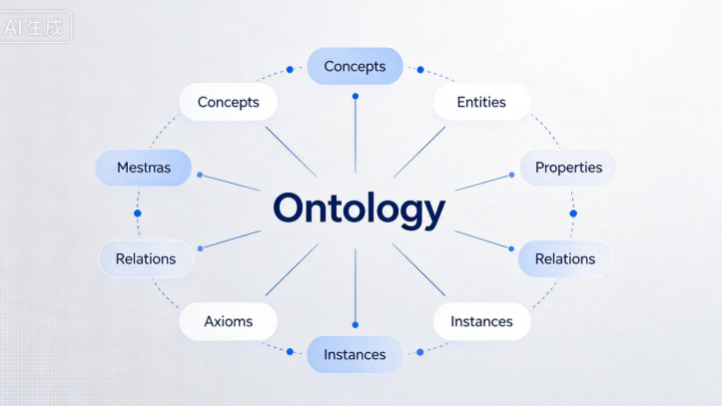
AI领域的Ontology(本体)是对领域概念、属性、相互关系进行显式、规范化定义的语义模型,提供知识的逻辑骨架,让机器可以理解、推理领域知识。
1 个月前
Harness 是包裹大模型、管控智能体执行流程、施加硬性约束与外部能力的整套运行控制系统。

9 个月前
LoRA(Low-Rank Adaptation)是一种对大模型进行“轻量级微调”的技术。

1 年前
联邦学习(Federated Learning)是一种分布式机器学习技术,旨在解决数据隐私与数据孤岛问题,允许多个参与方(如设备、机构)在不共享原始数据的情况下,协同训练机器学习模型。
1 年前
大模型的范式(paradigm)是指支撑其设计、训练和应用的核心方法论或框架,反映了其处理问题的基本模式。这一概念可以从多个维度理解,以下是关键要点: 1. 技术范式 自监督学习 大模型的核心训练方式,通过海量无标注数据(如文本、图像)进行预训练,利用掩码语言建模(如BERT)、自回归生成(如GPT)等任务学习通用表示。 规模化(Scaling Laws) 遵循"规模效应":模型参数量、数据量和算力同步扩大时,性能显著提升(如Chinchilla定律)。 Transformer架构 基于自注意力机制(Self-Attention)的模型结构,支持并行计算和长程依赖建模,成为大模型的基础骨架。 2. 功能范式 预训练+微调(Pretrain-Finetune) 先在通用数据上预训练,再针对下游任务微调(如分类、生成)。例如,BERT通过附加任务层适配不同场景。 提示学习(Prompt Learning) 通过设计自然语言提示(Prompt)激发模型潜能,减少微调需求(如GPT-3的few-shot learning)。 多模态统一建模 将文本、图像、视频等映射到统一语义空间(如CLIP、Flamingo),实现跨模态理解与生成。 3. 应用范式 生成式AI(Generative AI) 大模型的核心能力转向生成内容(文本、代码、图像等),如ChatGPT的对话生成、Stable Diffusion的图像合成。 AI即服务(AIaaS) 通过API或开放平台提供模型能力(如OpenAI API),降低技术使用门槛。 智能体(Agent)架构 大模型作为"大脑",结合工具调用(Tool Use)、记忆和规划,实现复杂任务自动化(如AutoGPT)。 4. 生态范式 开源与闭源并存 开源模型(如LLaMA、Stable Diffusion)推动社区创新,闭源模型(如GPT-4)侧重商业化。 数据飞轮效应 用户反馈数据持续优化模型,形成闭环(如ChatGPT基于人类反馈的强化学习RLHF)。 垂直领域适配 通用大模型通过领域适配(如医学、法律)释放专业价值(如Med-PaLM)。 5. 挑战与演进方向 效率问题:模型压缩(如量化、蒸馏)、稀疏化(如Mixture of Experts)。 对齐(Alignment):确保模型行为符合人类价值观(如RLHF技术)。 新架构探索:超越Transformer的潜在方案(如RWKV、Mamba等状态空间模型)。 总结 大模型的范式本质是通过规模化预训练获得通用能力,再通过灵活适配解决多样任务,其发展正从单一语言模型转向多模态、交互式、智能体化的综合系统。这一范式正在重塑AI研发和应用的基本逻辑。

1 年前
语料数据(Corpus Data)是指用于训练、验证和测试语言模型的大规模结构化或非结构化文本集合。

1 年前
ChatBI 是一种基于人工智能和自然语言处理技术的商业智能(Business Intelligence, BI)分析工具。与传统的 BI 工具不同,ChatBI 以对话交互为核心,用户可以像与人交流一样,通过自然语言对话来获取数据分析和业务洞察。这种模式大大降低了数据分析的门槛,使非技术用户也能够轻松地进行复杂的数据查询和分析。 核心功能与特点: ChatBI 的主要功能和特点体现在以下几个方面: 自然语言查询: 用户可以像和同事聊天一样,直接用中文或英文输入问题。例如,“去年各地区销售额排名”或者“本月客户流失率是多少?”。系统会自动理解意图,将语言转化为能够在数据库中执行的查询指令。 实时数据分析: ChatBI 能够连接企业的各类数据源(如数据库、Excel、ERP、CRM 等),实现实时的数据检索和分析。用户无需编写 SQL 或自定义脚本,就能得到最新的数据结果。 自动生成可视化报表: 在得到分析结果后,ChatBI 可以自动生成柱状图、折线图、饼图等多种可视化报表,帮助用户更直观地理解和展示数据。 智能洞察与建议: 结合大模型能力,ChatBI 不仅能回答具体数据问题,还能基于数据趋势主动给出业务建议。例如,自动识别异常值、预测业务走势、提醒关键风险点等。 多端集成与协作: ChatBI 支持网页、移动端、微信、钉钉等多平台接入,便于团队协作和信息共享。同时,具备权限管理和数据安全保障。 典型应用场景: ChatBI 在企业数据决策和日常运营中有广泛应用,主要包括: 日常经营分析:让管理层和业务人员随时随地查询销售、库存、利润等核心数据。 客户服务与支持:为客服团队提供快速查询客户信息、订单状态等能力,提高服务效率。 运营监控与预警:自动监控关键指标,及时发现异常,支持自动化报警。 数据驱动决策:辅助市场、财务、人力等部门做出基于数据的战略和战术决策。 技术原理与优势: ChatBI 结合了大语言模型(如 GPT)、语义理解、数据建模、知识图谱等前沿技术。它的显著优势包括: 极大降低了数据分析的技术门槛和沟通成本 提高了数据驱动决策的效率和准确性 促进了企业数据资产的流动和价值释放 未来发展趋势: 随着人工智能和大模型技术的进步,ChatBI 将更加智能化和自动化。例如,未来可能实现更深层的数据洞察、跨多源数据的联动分析、甚至自动提出业务优化建议。ChatBI 也有望成为企业智能办公的重要入口,为各类组织赋能。 总之,ChatBI 让数据分析变得像聊天一样简单,是企业智能化转型的重要工具。

1 年前
BERT(Bidirectional Encoder Representations from Transformers)是由Google于2018年发布的一种预训练语言模型,基于Transformer架构,用于自然语言处理(NLP)任务。它的双向(Bidirectional)上下文理解能力使其在文本理解、问答系统、文本分类等任务中表现卓越。 BERT的核心特点 1. 双向上下文理解 传统语言模型(如GPT)通常是单向的(从左到右或从右到左)。 BERT采用Masked Language Model(MLM,掩码语言模型),即在训练过程中随机遮挡部分词语,并让模型根据上下文预测这些被遮挡的词,从而实现双向理解。 2. 预训练+微调(Pre-training & Fine-tuning) 预训练(Pre-training):在海量无标注文本数据(如维基百科、BooksCorpus)上进行训练,使BERT学会通用的语言知识。 微调(Fine-tuning):针对具体任务(如情感分析、问答系统、命名实体识别)进行轻量级训练,只需少量数据,即可获得良好效果。 3. 基于Transformer架构 BERT使用多层Transformer编码器,通过自注意力(Self-Attention)机制高效建模文本中的远程依赖关系。 Transformer结构相比RNN和LSTM,更适合并行计算,处理长文本能力更强。 BERT的两大核心任务 Masked Language Model(MLM,掩码语言模型) 在训练时,随机遮挡输入文本中的15%单词,让模型根据上下文预测这些词。 这种方法使BERT学习到更深层次的语言表示能力。 Next Sentence Prediction(NSP,下一句预测) 让模型判断两个句子是否是相邻句: IsNext(相关):句子A和B是原始文本中相连的句子。 NotNext(无关):句子B是随机选择的,与A无关。 这一任务有助于提高BERT在问答、阅读理解等任务中的能力。 BERT的不同版本 BERT-Base:12层Transformer(L=12)、隐藏层768维(H=768)、12个自注意力头(A=12),总参数110M。 BERT-Large:24层Transformer(L=24)、隐藏层1024维(H=1024)、16个自注意力头(A=16),总参数340M。 DistilBERT:更小更快的BERT变体,参数量约为BERT的一半,但性能接近。 RoBERTa:改进版BERT,去除了NSP任务,并采用更大数据量进行训练,提高了性能。 BERT的应用 BERT可以应用于多种NLP任务,包括: 文本分类(如垃圾邮件检测、情感分析) 命名实体识别(NER)(如人名、地名、组织识别) 阅读理解(QA)(如SQuAD问答) 文本摘要 机器翻译 搜索引擎优化(SEO)(Google已将BERT用于搜索算法) BERT的影响 推动NLP进入预训练时代:BERT的成功引发了NLP领域的“预训练+微调”范式(如GPT、T5、XLNet等)。 提升搜索引擎性能:Google 在搜索引擎中使用BERT,提高查询理解能力。 加速AI技术发展:BERT的开源推动了自然语言处理技术在学术界和工业界的广泛应用。 总结 BERT是Transformer架构的双向预训练模型,通过MLM和NSP任务学习通用语言知识,在NLP领域取得巨大突破。它的成功奠定了现代大模型预训练+微调的范式,被广泛用于搜索、问答、文本分类等任务。


