时间序列预测对于零售、能源、金融和医疗保健等行业的决策至关重要。然而,开发基于机器学习的精准预测模型传统上需要大量针对特定数据集的调优和模型定制。
亚马逊Chronos是亚马逊科学团队开发的预训练时间序列预测模型库。它基于T5架构,通过将时间序列数据转换为令牌序列,以学习时间序列的“语言”,从而实现概率性时间序列预测。
与大型语言模型或视觉语言模型一样,Chronos 是一个基础模型,它从大型数据集中学习如何生成适用于各种任务的通用表示。 Chronos 背后的关键理念是将时间序列数据视为一种语言,并利用现成的 Transformer 架构进行建模。为了将实值时间序列观测值标记化为固定词汇表,先按绝对平均值对时间序列进行缩放,然后将缩放后的时间序列量化为固定数量的均匀分布的区间。
工作原理:
模型特点:
模型版本:Chronos共有5种型号,分别是tiny、mini、small、base和large,用户可根据数据集大小和任务需求选择,如面对小数据集时,可选择响应速度更快的tiny模型。


4 天前
Chief AI Officer(Chief Artificial Intelligence Officer),首席人工智能官。
8 天前
“如果技术不存在,就无从监管。” 黄仁勋进一步强调,如果AI产业无法蓬勃发展,“那就没什么可监管的了”。
9 天前
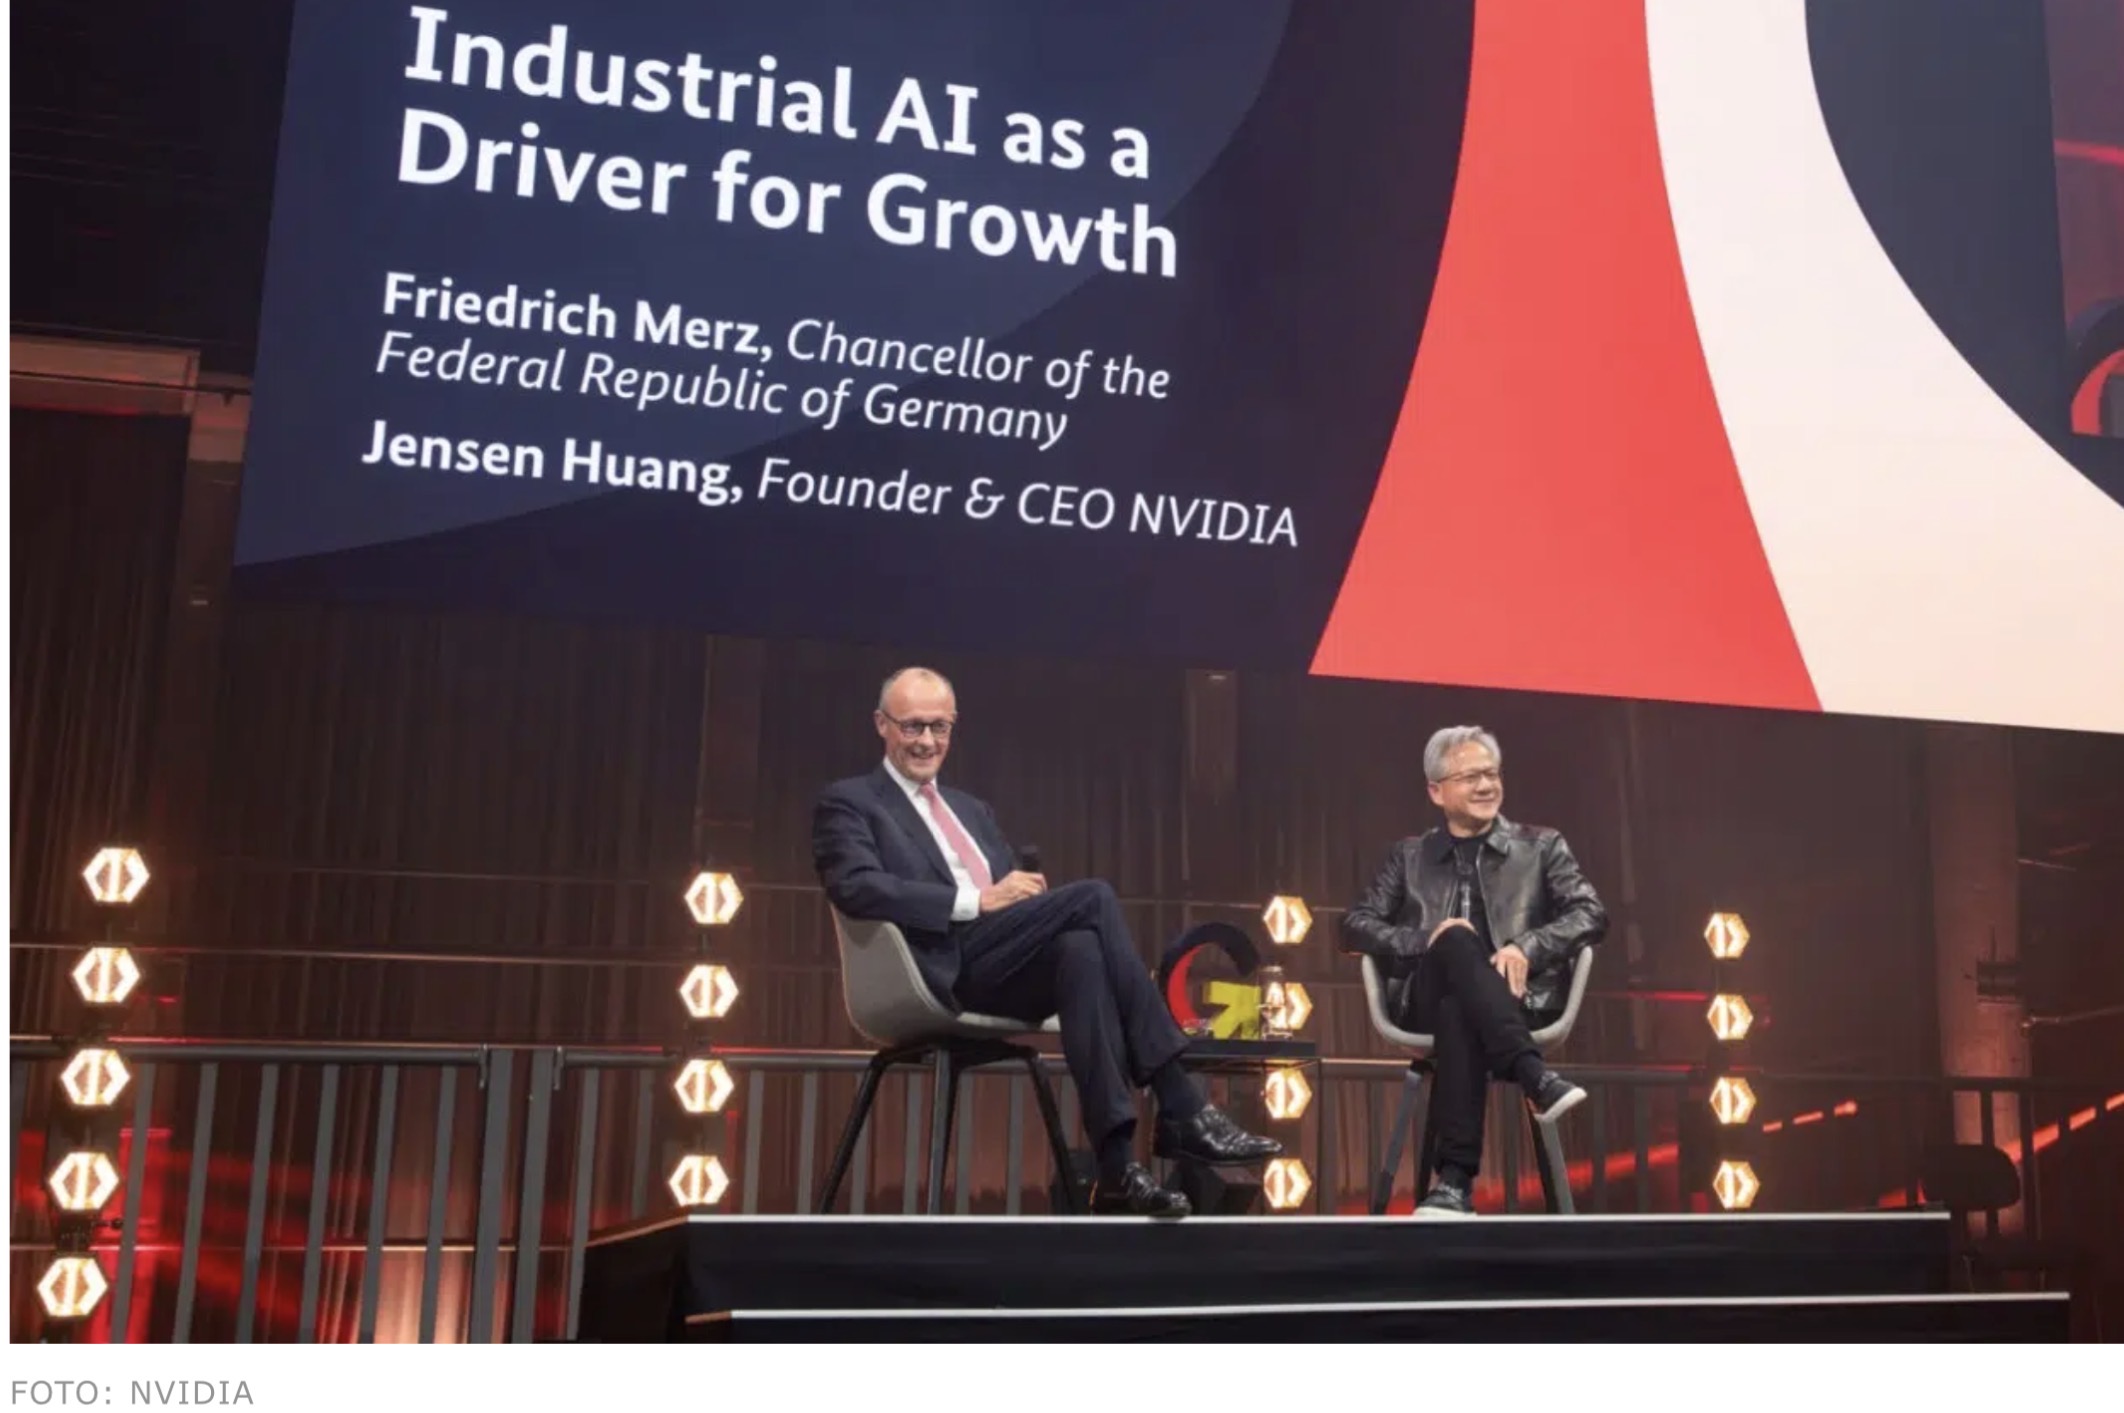
很多人以为 AI 时代的终局是“无人工厂”。黄仁勋在柏林给的版本,温柔得多,也更德国:电子不取代原子;它让原子被理解得更深。
12 天前
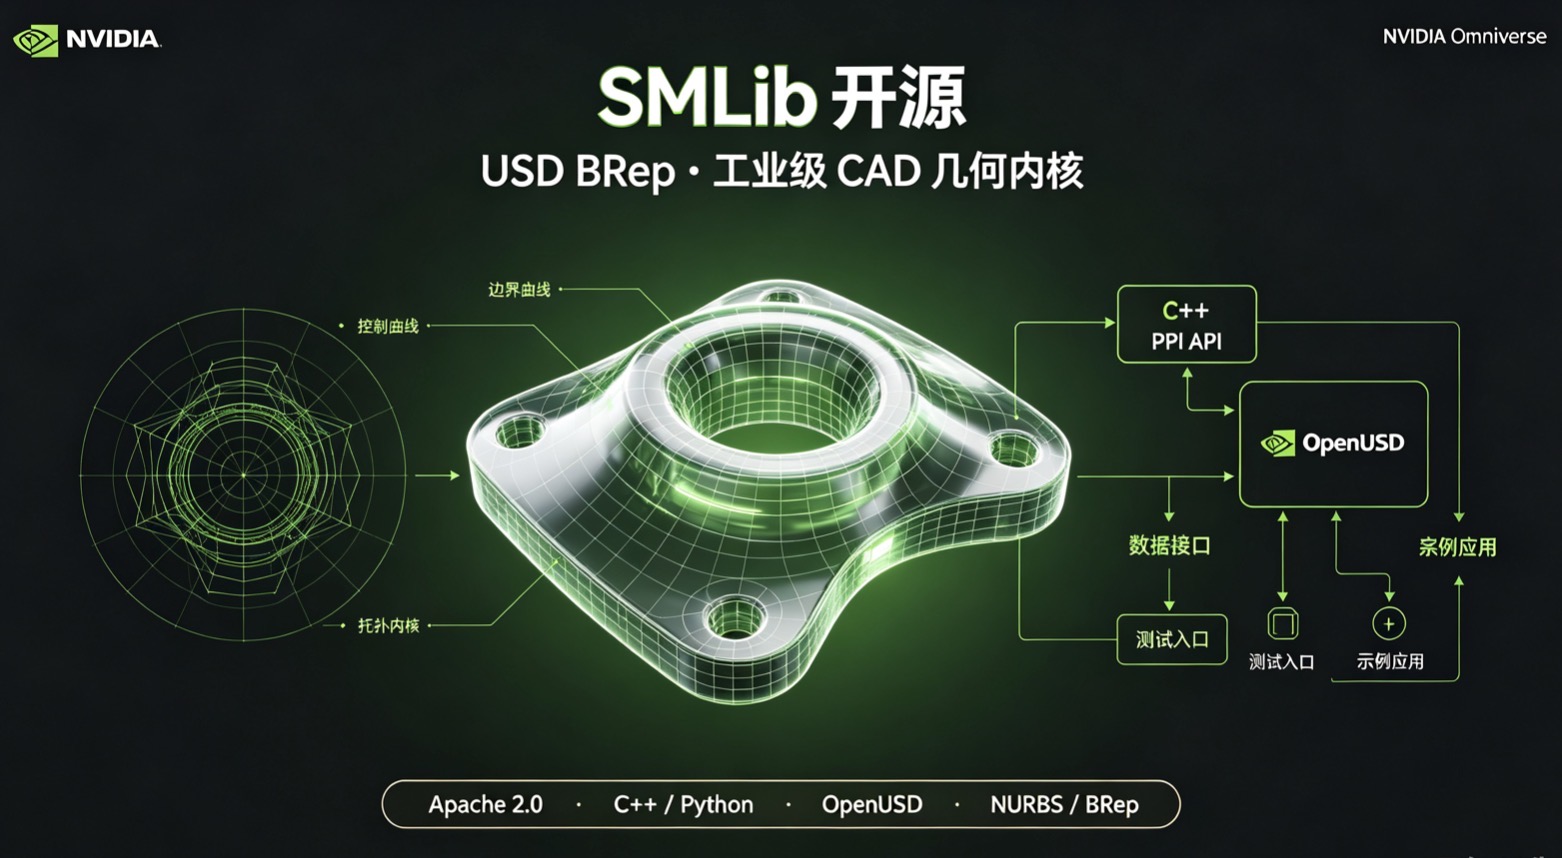
未来打通3D视觉表现和结构设计,可实现真正的高精可视化工业数字孪生。
3 个月前
西门子Xcelerator开放式数字商业平台作为正式发布生态合作伙伴"繁星计划",旨在发挥平台网络效应,与生态伙伴共享知识与技术资源,共创面向客户的解决方案,共赢数字化与低碳化新机遇。
9 个月前
简要结论:物理AI(Physical AI)正在成为人工智能发展的新方向,它的现实性在于能否真正理解并遵循物理规律。目前已有测试框架和硬件架构推动落地,但仍存在显著差距,现实应用需要长期迭代。 什么是“物理AI” 定义:物理AI强调让人工智能不仅能生成文本或图像,还要能在现实世界中遵循物理定律,具备“具身智能”(Embodied AI)的能力。 目标:解决 AI 在仿真到现实(Sim-to-Real)转化中的落地难题,让机器人、自动驾驶、数字孪生等应用更可靠。 当前研究进展 PAI-Bench 测试框架:佐治亚理工学院与卡内基梅隆大学团队提出的标准,用于评估 AI 是否理解物理规律。测试包含 2808 个真实案例,涵盖自动驾驶预测、机器人操作等场景。结果显示:人类准确率约 93.2%,而最佳 AI 模型仅 64.7%。 英伟达“物理AI”战略:在 CES 2026 提出,基于 Vera Rubin 超算平台 + Omniverse 仿真环境 + Jetson T4000 边缘硬件,构建闭环架构,强调“不要只生成像素,要生成行动”。 ✅ 现实性分析 优势: 技术驱动:硬件(GPU、边缘计算)和仿真平台(Omniverse)已具备支撑条件。 应用需求强烈:自动驾驶、机器人、工业制造等都需要 AI 遵循物理规律。 研究路径明确:已有标准化测试框架(PAI-Bench),为模型改进提供方向。 局限: 理解不足:现有模型在物理推理上的表现远低于人类水平。 数据难题:物理规律涉及连续性和复杂交互,难以通过大规模数据直接学习。 落地成本高:需要强算力、精细仿真和高性能硬件,短期内难以普及。 ⚠️ 风险与挑战 幻觉问题:AI可能生成视觉效果逼真但违反物理规律的结果。 安全性:在自动驾驶或机器人场景中,错误的物理推理可能导致事故。 标准缺失:虽然有 PAI-Bench,但行业尚未形成统一的评估体系。 综合评价 物理AI的现实性在于“方向明确、路径清晰,但短期难以完全落地”。 它更像是未来十年 AI 的关键突破口:从“生成像素”走向“生成行动”。目前仍处于探索阶段,但随着硬件、仿真和测试框架的成熟,物理AI有望逐步应用于自动驾驶、机器人和工业场景。
10 个月前
YOLO(You Only Look Once),这确实是目前计算机视觉领域最热门、应用最广泛的目标检测算法之一。 简单来说,如果把计算机看作一个学生,传统的检测算法像是让学生“拿着放大镜,一点点扫描图片里有什么”,而 YOLO 则是让学生“一眼扫过整张图,立刻说出图里有什么、在哪儿”。 这种“一眼识别”的特性,让 YOLO 在速度和准确性上取得了极佳的平衡。结合掌握的资料,这里为你详细拆解一下 YOLO 的核心原理、发展历程以及它在现实中的应用。 ? YOLO 的核心工作原理:像人眼一样“扫视” YOLO 的核心思想是将目标检测问题转化为一个回归问题。它不需要像旧算法(如 R-CNN)那样先猜区域再识别,而是通过一次神经网络计算,直接从图像像素回归出物体的位置和类别。 我们可以把它的工作流程想象成老师给班级分组: 网格划分(Grid Cells): 算法会将输入的图像划分为 S times S 个小格子(例如 7x7)。如果一个物体的中心点落在某个格子里,那个格子就“负责”检测这个物体。 边界框预测(Bounding Boxes): 每个格子会预测出几个边界框(例如 2 个),每个框包含 5 个参数:中心坐标 (x, y)、宽 w、高 h 以及一个置信度(表示框里确实有物体的概率)。 类别概率(Class Probabilities): 同时,每个格子还会预测这个框内物体属于各个类别的概率(比如是猫的概率 80%,是狗的概率 5%)。 非极大值抑制(NMS): 因为多个格子可能会检测到同一个物体,最后会通过 NMS 算法“去重”,保留得分最高的框,去掉重叠度高且得分低的框。 ? 从 V1 到 V8:YOLO 的进化之路 YOLO 算法自 2015 年诞生以来,经历了多次重大的架构升级。为了让你更直观地了解,这里整理了主要版本的演进逻辑: YOLOv1: 首次提出“单阶段检测”概念,将检测视为回归问题。 开创性工作,速度快,但小目标检测精度一般。 YOLOv2/v3: 引入 Anchor Boxes(先验框)和多尺度预测。 检测精度大幅提升,尤其是小物体。v3 成为经典里程碑。 YOLOv4: 集成了大量优化技巧(CSPDarknet, PANet, Mosaic数据增强)。 在保持速度的同时,精度达到了当时的顶尖水平。 YOLOv5: 基于 PyTorch 实现,工程化极佳。 极易上手,提供了从小到大的多种模型(s/m/l/x),部署方便,工业界主流。 YOLOv8: 最新主流版本,进一步优化了架构和损失函数。 性能更强,支持分类、检测、分割等多种任务,是目前的首选之一。 ? 为什么 YOLO 如此受欢迎? ⚡ 极快的速度: 由于只需要“看一次”,YOLO 可以轻松达到实时处理(如 45 FPS 甚至更高),非常适合处理视频流。 ? 全局视野: 它在预测时利用了整张图的上下文信息,因此在背景中误检(把背景当作物体)的概率比两阶段算法要低。 ?️ 强大的泛化能力: 它学习到的特征具有很好的通用性,迁移到其他数据集上通常也能取得不错的效果。 ? 实际应用场景 基于 YOLO 的这些特性,它在很多领域都有广泛的应用: ? 智慧安防: 实时监控画面中的人体检测、异常行为识别。 ? 自动驾驶: 识别道路上的车辆、行人、交通标志,为车辆决策提供依据。 ? 工业质检: 在生产线上快速识别产品缺陷、零件缺失或错位。 ? 医疗影像: 辅助医生识别 X 光片或 CT 图像中的病变区域(如肿瘤)。 ? 物流分拣: 识别包裹上的条形码或分类标签。 ? 对初学者的建议 如果想入门或使用 YOLO 进行图像识别: 新手入门: 推荐从 YOLOv5 或 YOLOv8 开始。它们的官方文档非常完善,代码(通常是 PyTorch 版本)易于理解,且社区支持丰富。 数据准备: 图像识别的效果很大程度上取决于数据。你需要准备标注好的数据集(通常标注工具会生成 .txt 或 .xml 文件,标明物体的类别和坐标)。 硬件要求: 虽然 YOLO 很快,但训练过程通常还是需要 GPU(如 NVIDIA 显卡)来加速。

10 个月前
Nova 2是亚马逊于2025年12月在re:Invent 全球大会上推出的新一代基础模型家族,共包含4款模型,均需通过Amazon Bedrock平台使用,兼顾行业领先的性价比与多场景适配性,具体介绍如下 : 1. Nova 2 Lite: 主打快速、高性价比的日常推理任务,可处理文本、图像和视频输入并生成文本。能通过调节“思考”深度平衡智能、速度与成本,适合客服聊天机器人、文档处理等场景。在基准测试中,它对标Claude Haiku 4.5、GPT - 5 Mini等模型,多数项目表现持平或更优。 2. Nova 2 Pro(预览版): 是该家族中智能度最高的推理模型,可处理文本、图像、视频和语音输入并生成文本。适配代理编码、长期规划等复杂任务,还能作为“教师模型”向小型模型传递能力,在与Claude Sonnet 4.5、Gemini 2.5 Pro等主流模型的对比中,多项基准测试表现出色。 3. Nova 2 Sonic: 专注端到端语音交互的模型,能实现类人化实时对话。它支持多语言与丰富音色,拥有100万token上下文窗口,可支撑长时交互,还能与Amazon Connect等语音服务、对话框架无缝集成,适配客服、AI助手等语音场景。 4. Nova 2 Omni: 业内首款统一多模态推理与生成模型,可处理文本、图像等多种输入,还能同时生成文本和图像。它能一次性处理海量多格式内容,比如数百页文档、数小时音频等,适合营销素材一站式制作等需要整合多类信息的场景。 这4款模型均具备100万token上下文窗口,且内置网页查找和代码执行能力,能保障回答的时效性与实用性 。