易拍即识:基于大模型技术的智能文字识别工具
易拍即识是一款基于大模型技术的文字识别工具,旨在帮助用户快速、准确地提取图片中的目标文字。它由济南通悟人工智能科技有限公司开发,凭借其技术创新和实用性,在2024年「Gitee AI & 天数智芯创新应用大赛」中荣获三等奖。
易拍即识的主要功能包括:
易拍即识依托先进的大模型技术,具备以下技术优势:
易拍即识广泛应用于以下场景:
易拍即识凭借其高效、便捷的特点,受到了用户的广泛好评。在「Gitee AI & 天数智芯创新应用大赛」中,其技术创新和实用性得到了评委和观众的高度认可。此外,易拍即识的推出也标志着济南通悟人工智能科技有限公司在大模型技术应用领域的进一步突破。
易拍即识团队表示,未来将继续致力于AI技术的研发和应用,为用户提供更多高效、便捷的解决方案,推动国内AI生态的繁荣发展。
通过易拍即识,用户可以轻松实现图片文字的智能提取,提升工作效率和生活便利性。如果您对这款工具感兴趣,可以访问其官方网站了解更多详情。
免责声明:本网站仅提供网址导航服务,对链接内容不负任何责任或担保。

10 个月前
YOLO(You Only Look Once),这确实是目前计算机视觉领域最热门、应用最广泛的目标检测算法之一。 简单来说,如果把计算机看作一个学生,传统的检测算法像是让学生“拿着放大镜,一点点扫描图片里有什么”,而 YOLO 则是让学生“一眼扫过整张图,立刻说出图里有什么、在哪儿”。 这种“一眼识别”的特性,让 YOLO 在速度和准确性上取得了极佳的平衡。结合掌握的资料,这里为你详细拆解一下 YOLO 的核心原理、发展历程以及它在现实中的应用。 ? YOLO 的核心工作原理:像人眼一样“扫视” YOLO 的核心思想是将目标检测问题转化为一个回归问题。它不需要像旧算法(如 R-CNN)那样先猜区域再识别,而是通过一次神经网络计算,直接从图像像素回归出物体的位置和类别。 我们可以把它的工作流程想象成老师给班级分组: 网格划分(Grid Cells): 算法会将输入的图像划分为 S times S 个小格子(例如 7x7)。如果一个物体的中心点落在某个格子里,那个格子就“负责”检测这个物体。 边界框预测(Bounding Boxes): 每个格子会预测出几个边界框(例如 2 个),每个框包含 5 个参数:中心坐标 (x, y)、宽 w、高 h 以及一个置信度(表示框里确实有物体的概率)。 类别概率(Class Probabilities): 同时,每个格子还会预测这个框内物体属于各个类别的概率(比如是猫的概率 80%,是狗的概率 5%)。 非极大值抑制(NMS): 因为多个格子可能会检测到同一个物体,最后会通过 NMS 算法“去重”,保留得分最高的框,去掉重叠度高且得分低的框。 ? 从 V1 到 V8:YOLO 的进化之路 YOLO 算法自 2015 年诞生以来,经历了多次重大的架构升级。为了让你更直观地了解,这里整理了主要版本的演进逻辑: YOLOv1: 首次提出“单阶段检测”概念,将检测视为回归问题。 开创性工作,速度快,但小目标检测精度一般。 YOLOv2/v3: 引入 Anchor Boxes(先验框)和多尺度预测。 检测精度大幅提升,尤其是小物体。v3 成为经典里程碑。 YOLOv4: 集成了大量优化技巧(CSPDarknet, PANet, Mosaic数据增强)。 在保持速度的同时,精度达到了当时的顶尖水平。 YOLOv5: 基于 PyTorch 实现,工程化极佳。 极易上手,提供了从小到大的多种模型(s/m/l/x),部署方便,工业界主流。 YOLOv8: 最新主流版本,进一步优化了架构和损失函数。 性能更强,支持分类、检测、分割等多种任务,是目前的首选之一。 ? 为什么 YOLO 如此受欢迎? ⚡ 极快的速度: 由于只需要“看一次”,YOLO 可以轻松达到实时处理(如 45 FPS 甚至更高),非常适合处理视频流。 ? 全局视野: 它在预测时利用了整张图的上下文信息,因此在背景中误检(把背景当作物体)的概率比两阶段算法要低。 ?️ 强大的泛化能力: 它学习到的特征具有很好的通用性,迁移到其他数据集上通常也能取得不错的效果。 ? 实际应用场景 基于 YOLO 的这些特性,它在很多领域都有广泛的应用: ? 智慧安防: 实时监控画面中的人体检测、异常行为识别。 ? 自动驾驶: 识别道路上的车辆、行人、交通标志,为车辆决策提供依据。 ? 工业质检: 在生产线上快速识别产品缺陷、零件缺失或错位。 ? 医疗影像: 辅助医生识别 X 光片或 CT 图像中的病变区域(如肿瘤)。 ? 物流分拣: 识别包裹上的条形码或分类标签。 ? 对初学者的建议 如果想入门或使用 YOLO 进行图像识别: 新手入门: 推荐从 YOLOv5 或 YOLOv8 开始。它们的官方文档非常完善,代码(通常是 PyTorch 版本)易于理解,且社区支持丰富。 数据准备: 图像识别的效果很大程度上取决于数据。你需要准备标注好的数据集(通常标注工具会生成 .txt 或 .xml 文件,标明物体的类别和坐标)。 硬件要求: 虽然 YOLO 很快,但训练过程通常还是需要 GPU(如 NVIDIA 显卡)来加速。
2 年前
PaddleOCR 是基于飞桨深度学习开源框架的文字识别开发套件,添加了许多 PaddleOCR 算法模型挑战赛冠军方案。 PaddleOCR目前不仅提供了通用场景下的中英文模型,也提供了专门在英文场景下训练的模型。除此之外也提供覆盖80个语言的小语种模型
2 天前
AI并非效率工具,而是商业决策的核心伙伴。
5 天前
Chief AI Officer(Chief Artificial Intelligence Officer),首席人工智能官。
9 天前
“如果技术不存在,就无从监管。” 黄仁勋进一步强调,如果AI产业无法蓬勃发展,“那就没什么可监管的了”。
9 天前
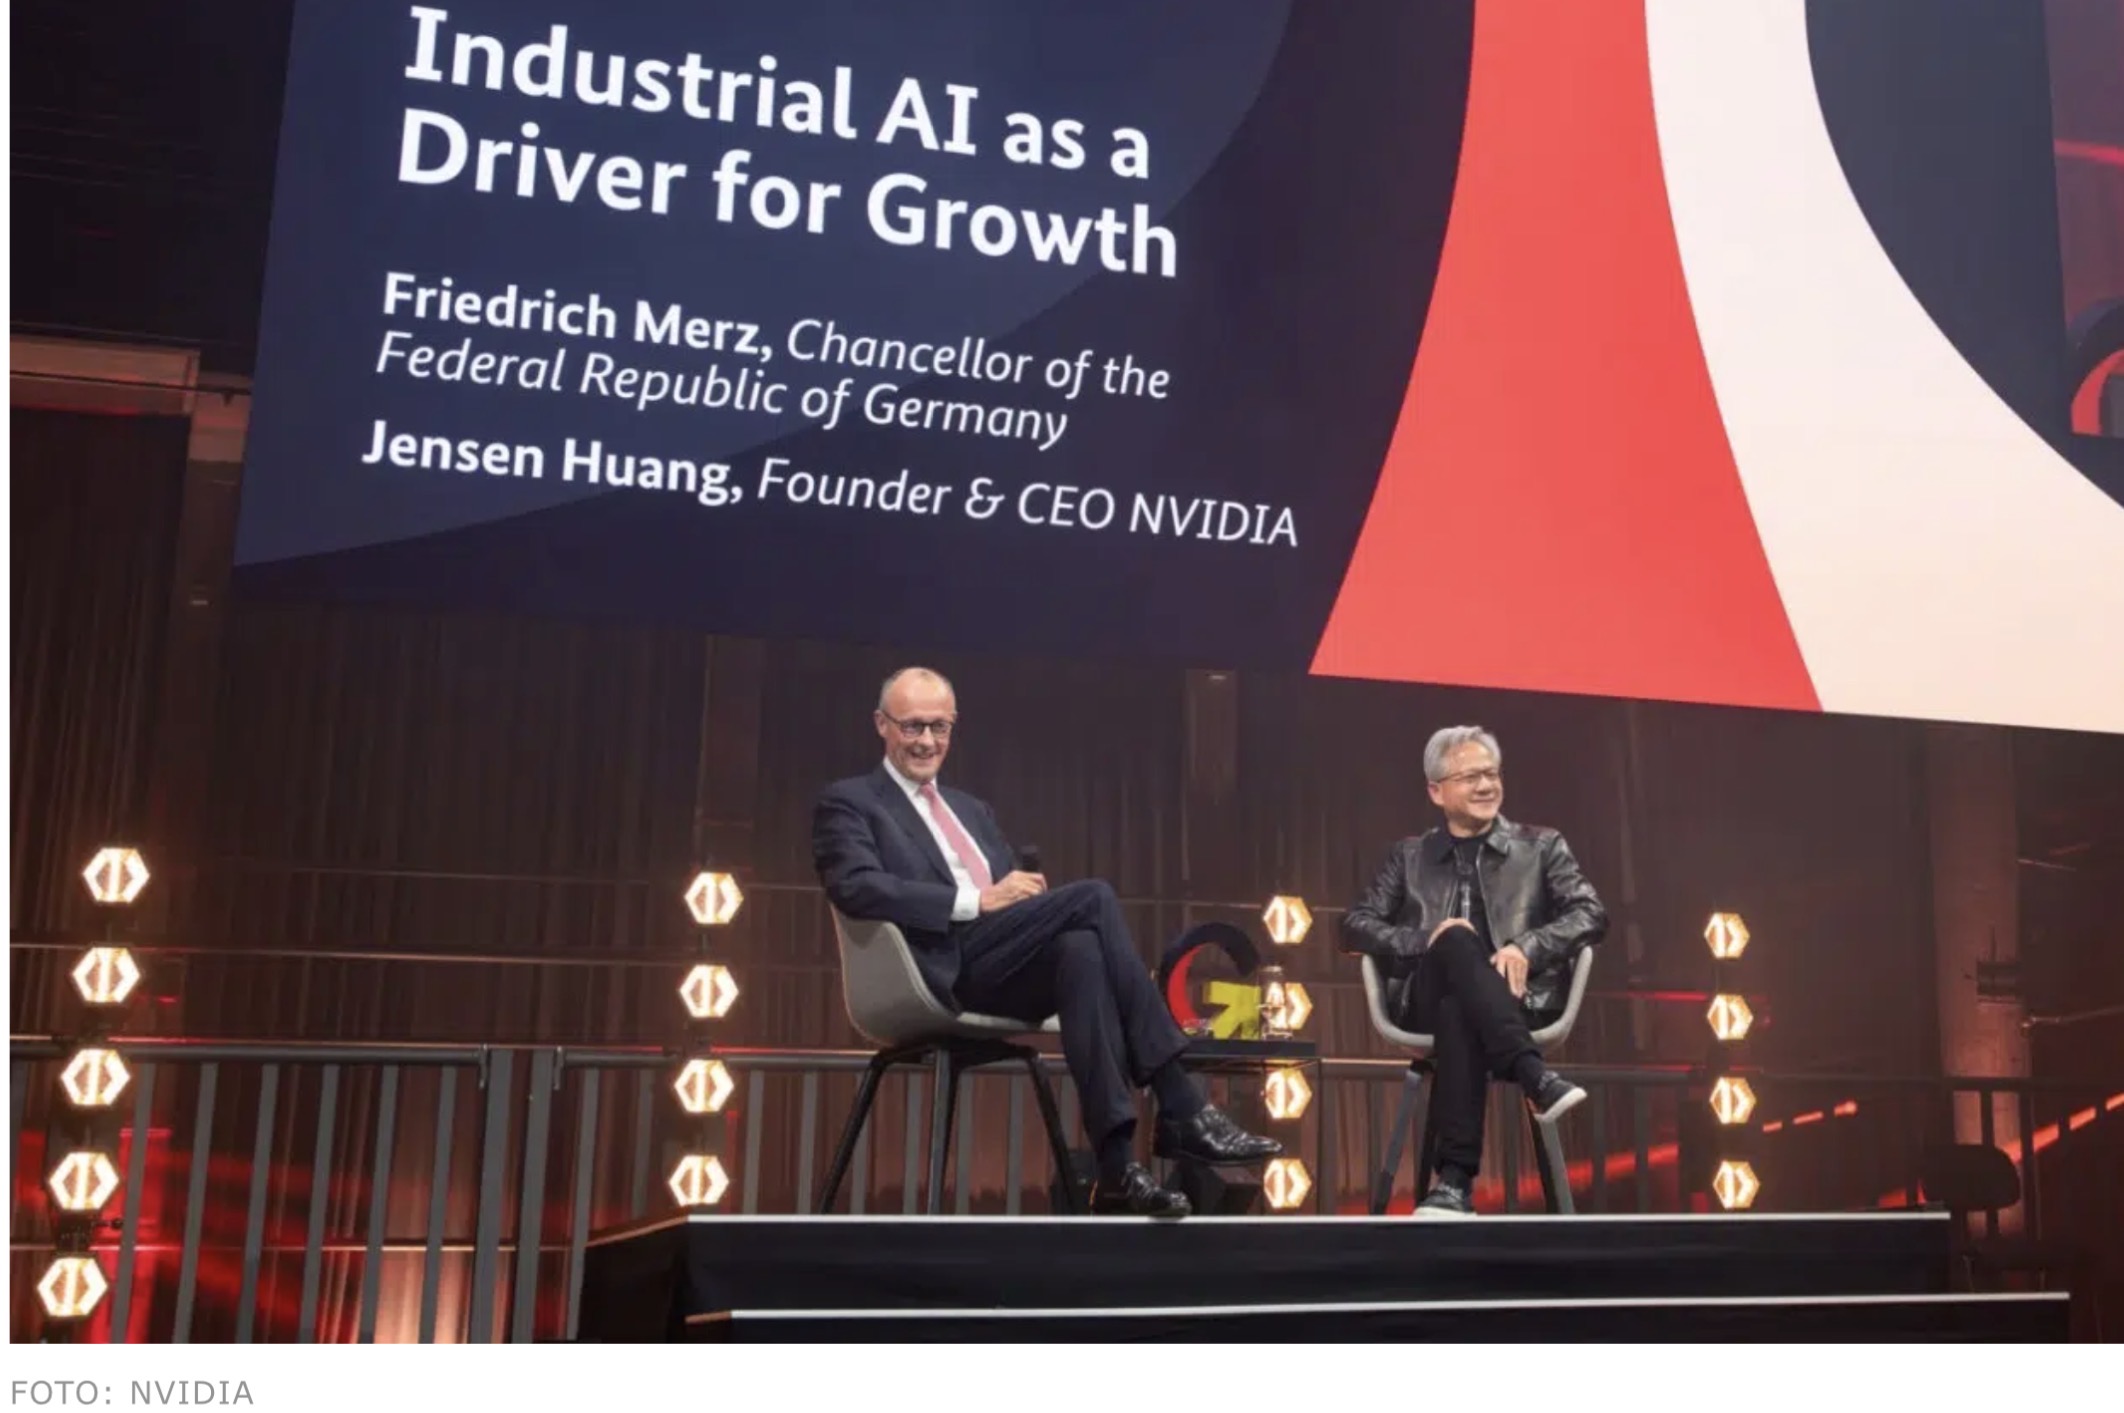
很多人以为 AI 时代的终局是“无人工厂”。黄仁勋在柏林给的版本,温柔得多,也更德国:电子不取代原子;它让原子被理解得更深。
11 天前
Next.js 是一个开源 React 框架,用于构建全栈 Web 应用。
12 天前
Node Package Manager (NPM)是 Node.js 平台的官方包管理器