大语言模型(LLM)在企业组织中的应用日益广泛,许多企业都将其整合到 AI 应用中。虽然从基础模型着手十分高效,但需要花费一定的精力才能将它们整合到生产就绪型环境中。NVIDIA NIM 简化了这一过程,使企业能够在数据中心、云、工作站和 PC 等任何位置运行 AI 模型。

专为企业设计的 NIM 提供一整套预构建云原生微服务,这些微服务能够被轻松地整合到现有基础设施中。这些微服务经过精心的维护和持续的更新,具有开箱即用的性能,并确保您能够获得 AI 推理技术的最新进展。
适用于大语言模型的全新 NVIDIA NIM
基础模型的增长源于其能够满足各种企业需求的能力,但没有任何一个单一的模型能够完全满足企业的需求,企业通常会根据特定的数据需求和 AI 应用工作流,在其用例中使用不同的基础模型。
考虑到企业需求的多样化,我们扩大了 NIM 的阵容,涵盖了 Mistral-7B、Mixtral-8x7B 和 Mixtral-8x22B,这三个基础模型在特定任务中的表现都十分出色。

图 1. 新的 Mixtral 8x7B Instruct NIM 可从 NVIDIA API 中获取
Mistral 7B NIM
Mistral 7B Instruct 模型在文本生成和语言理解任务中表现出色。该模型可在单个 GPU 上运行,非常适合语言翻译、内容生成和聊天机器人等应用。将 Mistral 7B NIM 部署至 NVIDIA 数据中心 GPU 后,开发者在内容生成任务中可实现的开箱即用性能(token/秒),其性能最多可提升至没有使用 NIM 时的 2.3 倍。

图 2. Mistral 7B NIM 提高了内容生成的吞吐量
基于 1 个 NVIDIA Tensor Core GPU,输入 500 个 token,输出 2,000 个 token。NIM 开启时:FP8。吞吐量为 5,697 token/秒,TTFT 为 0.6 秒,ITL 为 26 毫秒。NIM 关闭时:FP16。吞吐量为 2,529 token/秒,TTFT 为 1.4 秒,ITL 为 60 毫秒。
Mixtral-8x7B 和
Mixtral-8x22B NIM
Mixtral-8x7B 和 Mixtral-8x22B 模型采用混合专家(MoE)架构提供快速且经济高效的推理。这两个模型在总结、问题解答和代码生成等任务中表现出色,非常适合需要实时响应的应用。
相较无 NIM 运行的情况,NIM 可以提高这两种模型的开箱即用性能。当用于内容生成且在 1 个 NVIDIA Tensor Core GPU 上运行时,Mixtral-8x7B NIM 的吞吐量最多可提高 4.1 倍。在内容生成和翻译用例中,Mixtral-8x22B NIM 的吞吐量最多可提高 2.9 倍。

图 3. Mixtral 8x7B NIM 提高了内容生成的吞吐量
输入 500 个 token,输出 2,000 个 token。200 个并发请求。NIM 开启时:FP8。吞吐量为 9,410 token/秒。TTFT 为 740 毫秒,ITL 为 21 毫秒。NIM 关闭时:FP16。吞吐量为 2,300 token/秒,TTFT 为 1,321 毫秒,ITL 为 86 毫秒。

图 4. Mixtral 8x22B NIM 提高了内容生成和翻译的吞吐量
输入 1,000 个 token,输出 1,000 个 token。250 个并发请求。NIM 开启时:吞吐量为 6,070 token/秒,TTFT 为 3 秒,ITL 为 38 毫秒。NIM 关闭时:吞吐量为 2,067 token/秒,TTFT 为 5 秒,ITL 为 116 毫秒。
借助 NVIDIA NIM 加速 AI 应用部署
开发者可以使用 NIM 缩短构建适用于生产部署的 AI 应用所需的时间,同时还能提高 AI 推理效率,并降低运营成本。借助 NIM,经过优化的 AI 模型实现了容器化,为开发者带来了以下优势:
性能和规模
这些云驱动的微服务可提供低延迟、高吞吐量并可以轻松扩展的 AI 推理,使用 Llama 3 70B NIM,最多可将吞吐量提高 5 倍。NIM 还支持精确的微调模型,无需从头开始构建即可实现超高的准确性,进一步提高了 AI 推理性能。
易于使用
通过简化与现有系统的整合来加快进入市场的速度,并在 NVIDIA 加速基础设施上提供最佳性能。借助专为企业使用而设计的 API 和工具,开发者可以实现其 AI 能力的最大化。
安全性和易管理性
确保您的 AI 应用和数据具有强大的可控性和安全性。通过 NVIDIA AI Enterprise,NIM 支持在任何基础设施上的灵活自托管部署,提供企业级软件、严格的验证以及与 NVIDIA AI 专家的直接连线。
AI 推理的前景:
NVIDIA NIM 及其他延伸
NVIDIA NIM 代表了 AI 推理领域的重大进步。随着各行各业对 AI 应用需求的日益增长,高效部署这些应用变得至关重要。想要利用 AI 变革力量的企业可以使用 NVIDIA NIM,将预构建的云原生微服务轻松整合到现有系统中,以此加快产品推出速度,保持在创新领域的领先地位。
未来的 AI 推理将超越单个 NVIDIA NIM。随着对先进 AI 应用的需求不断增长,连接多个 NVIDIA NIM 将变得至关重要。这种微服务网络将带来能够协同工作和适应各种任务的高度智能化应用,从而深入改变我们使用技术的方式。如要在您的基础设施上部署 NIM 推理微服务,请查看“使用 NVIDIA NIM 部署生成式 AI 的简单指南”:
https://developer.nvidia.com/zh-cn/blog/a-simple-guide-to-deploying-generative-ai-with-nvidia-nim/
NVIDIA 定期发布新的 NIM,为企业提供最强大的 AI 模型,助企业应用一臂之力。请访问 API 目录,查找适用于 LLM、视觉、检索、3D 和数字生物学模型的最新 NVIDIA NIM:
https://build.nvidia.com/meta/llama3-8b?nvid=nv-int-tblg-491613
信息来源:Nvidia英伟达中国

4 天前
Chief AI Officer(Chief Artificial Intelligence Officer),首席人工智能官。
8 天前
“如果技术不存在,就无从监管。” 黄仁勋进一步强调,如果AI产业无法蓬勃发展,“那就没什么可监管的了”。
8 天前
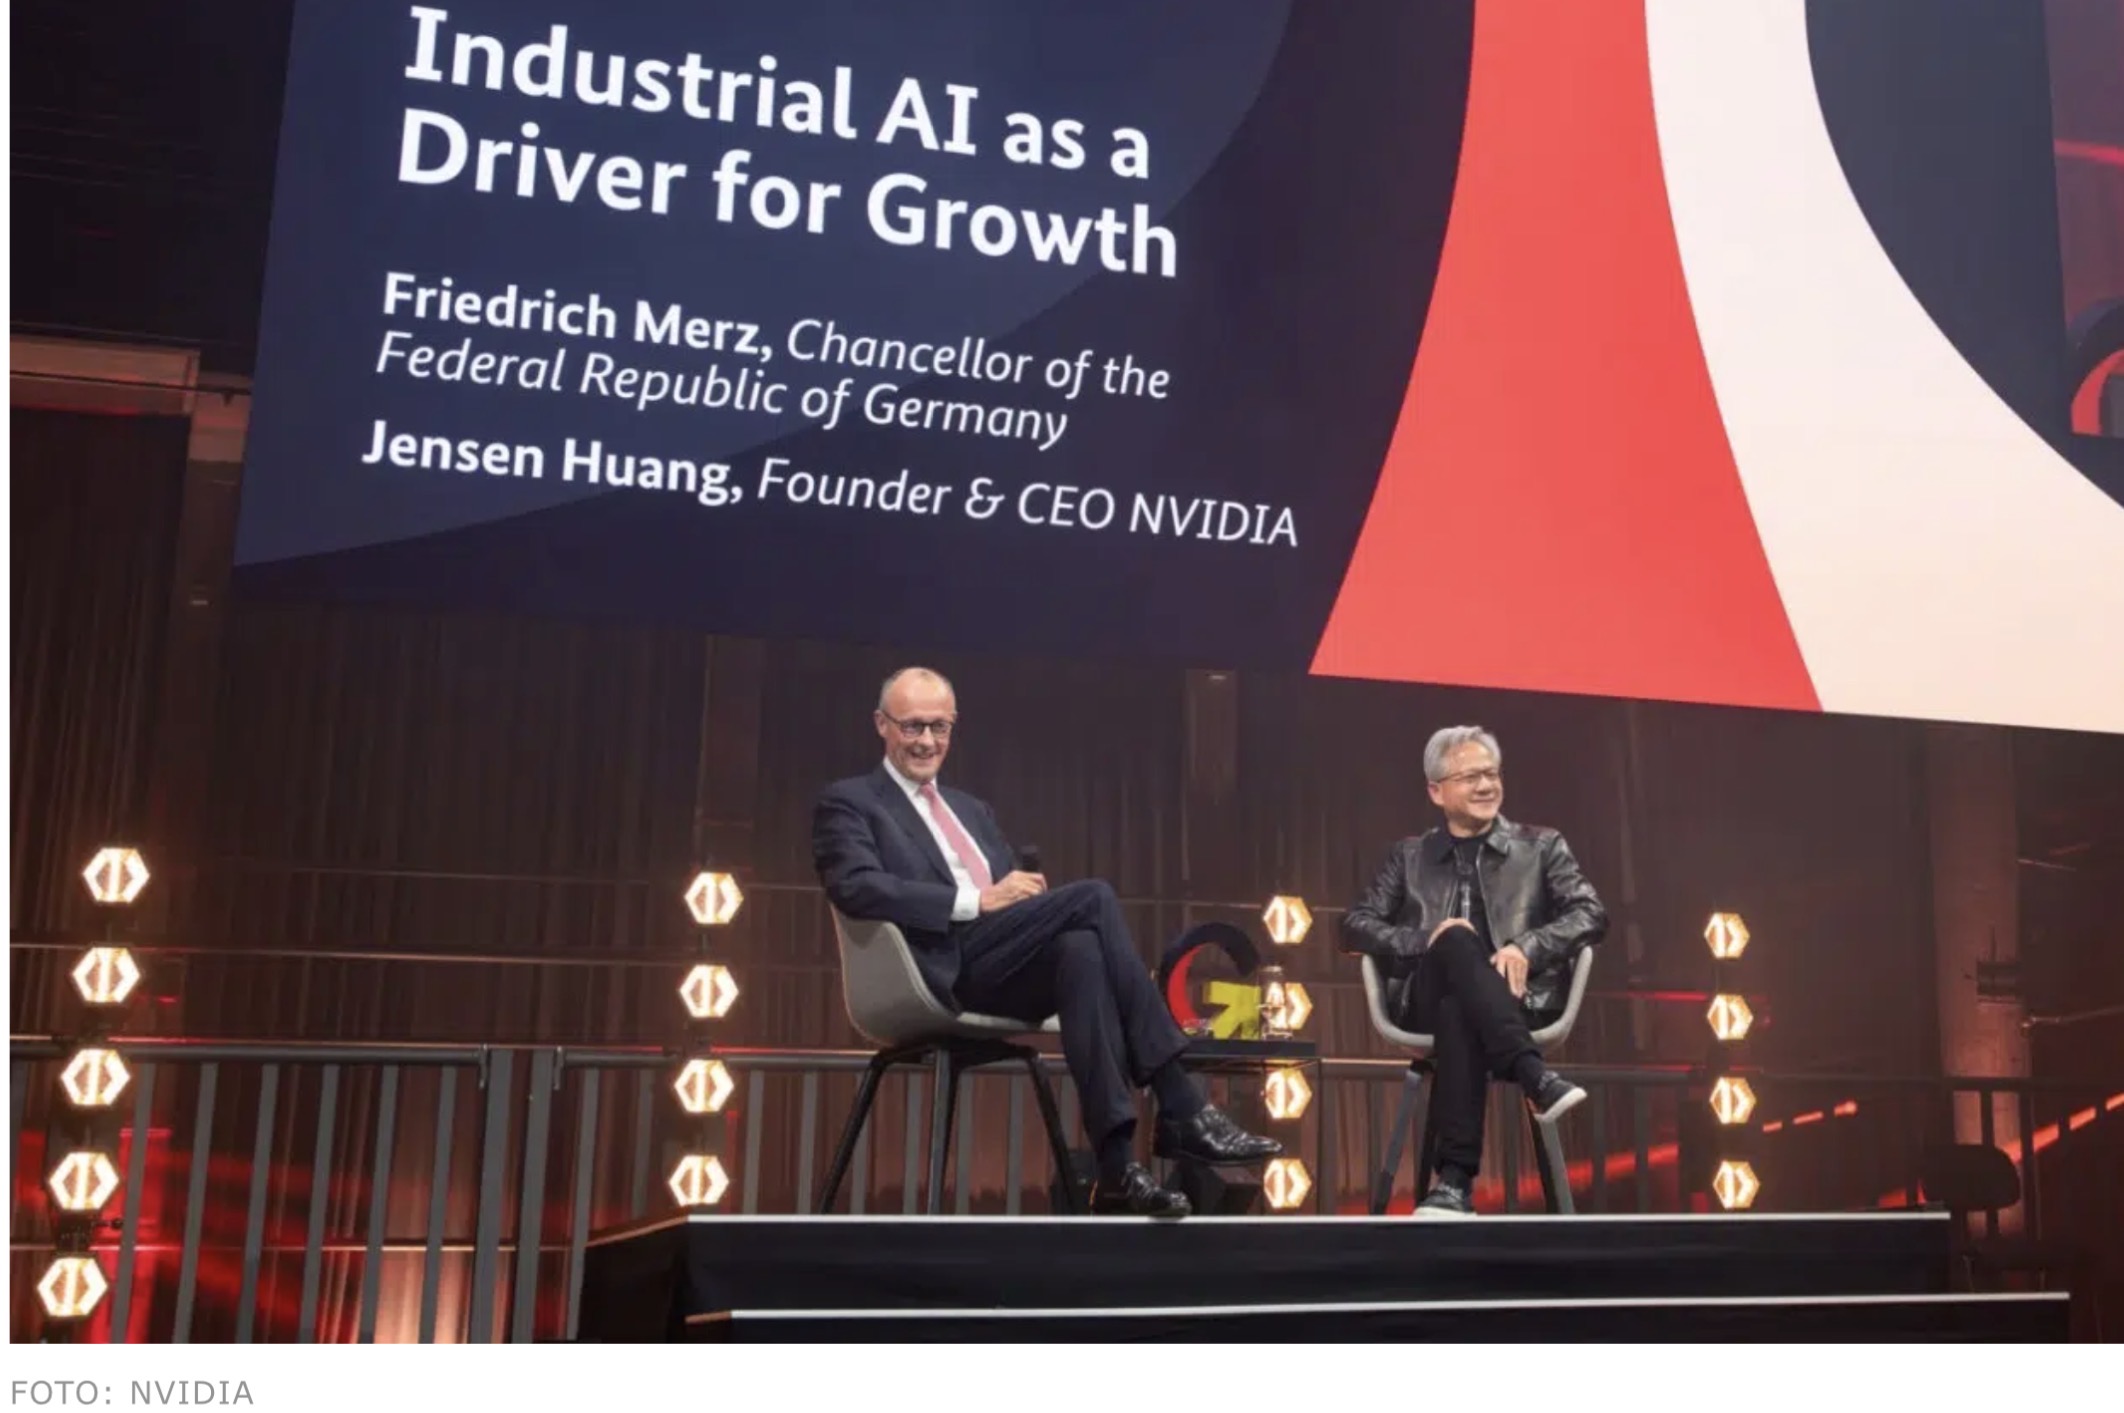
很多人以为 AI 时代的终局是“无人工厂”。黄仁勋在柏林给的版本,温柔得多,也更德国:电子不取代原子;它让原子被理解得更深。
12 天前
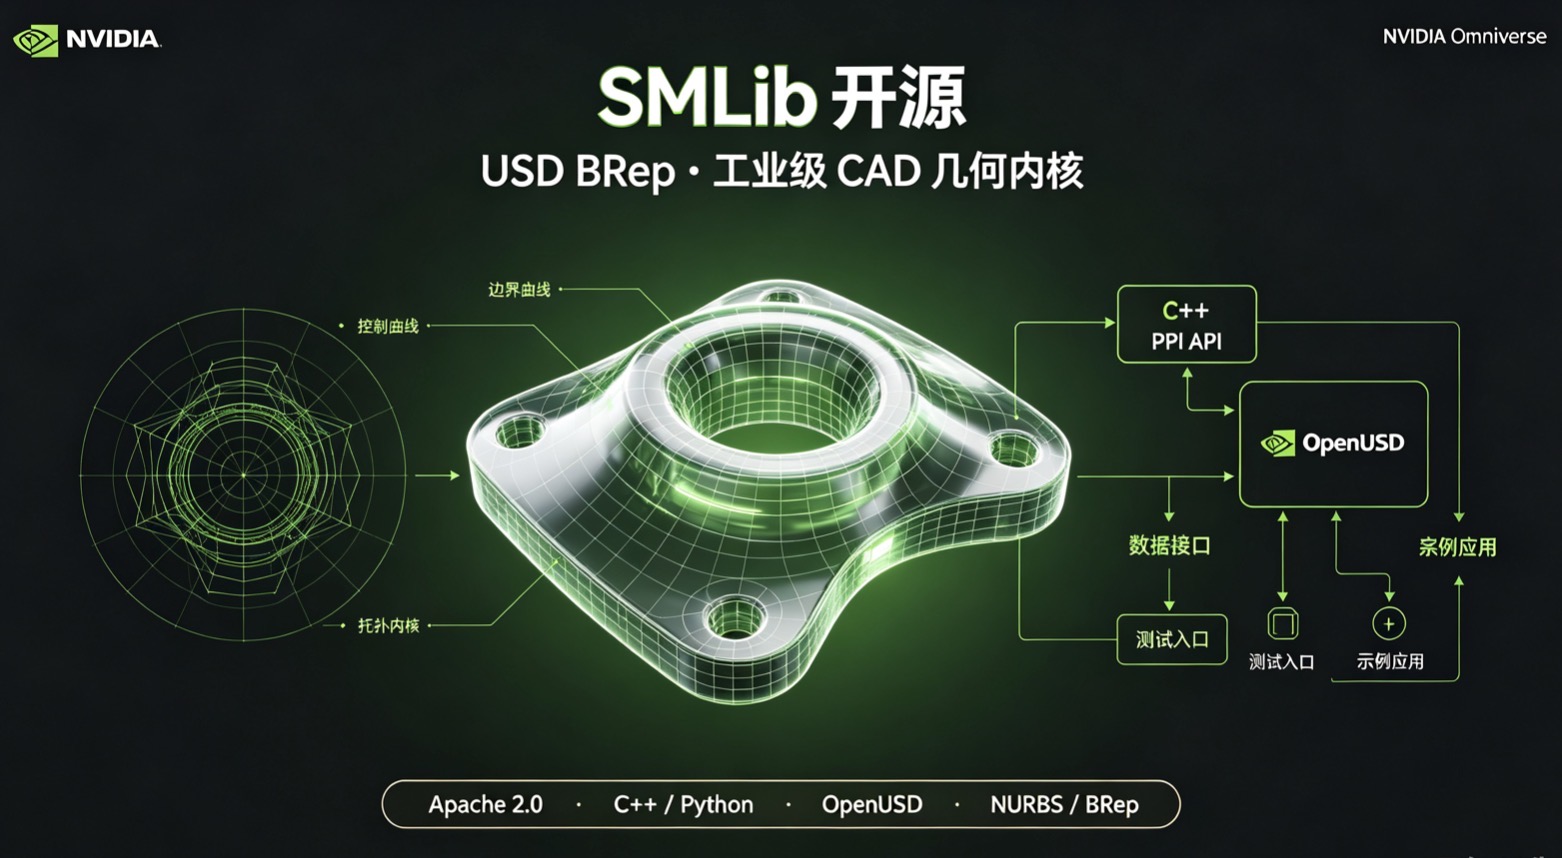
未来打通3D视觉表现和结构设计,可实现真正的高精可视化工业数字孪生。
3 个月前
西门子Xcelerator开放式数字商业平台作为正式发布生态合作伙伴"繁星计划",旨在发挥平台网络效应,与生态伙伴共享知识与技术资源,共创面向客户的解决方案,共赢数字化与低碳化新机遇。

9 个月前
这正是当前 AI 视频生成领域最前沿的突破方向。你提出的这个问题,本质上是在问如何让 AI 从“画皮”进阶到“画骨”——即不仅画面好看,运动逻辑也要符合现实世界的物理法则。 结合最新的技术进展(如 2025 年的相关研究),要让 AI 生成符合真实规律的视频,我们可以通过以下几种“高级语言描述法”来与模型沟通: 1. 使用“力提示”技术:像导演一样指挥物理力 ? 这是谷歌 DeepMind 等团队提出的一种非常直观的方法。你不需要懂复杂的物理公式,只需要在提示词中描述“力”的存在。 描述力的方向与强度: 你可以直接告诉 AI 视频中存在某种力。例如,不只是写“旗帜飘动”,而是写“旗帜在强风中剧烈飘动”或“气球被轻轻向上吹起”。 区分全局力与局部力: 全局力(风、重力): 影响整个画面。例如:“Global wind force blowing from left to right”(从左到右的全局风力)。 局部力(碰撞、推力): 影响特定点。例如:“A ball rolling after being kicked”(球被踢后滚动)。 效果: AI 模型(如 CogVideoX 结合特定模块)能理解这些力的矢量场,从而生成符合动力学的运动,比如轻的物体被吹得更远,重的物体移动缓慢。 2. 调用“思维链”与物理常识:让 LLM 当质检员 ? 有时候直接描述很难精准,我们可以借助大型语言模型(LLM)作为“中间人”来审核物理逻辑。这种方法(如匹兹堡大学的 PhyT2V)利用 LLM 的推理能力。 分步描述(Chain-of-Thought): 你可以在提示词中要求 AI “思考过程”。例如,不只是生成“水倒入杯子”,而是引导它:“首先,水从壶嘴流出,形成抛物线;然后,水撞击杯底,产生涟漪;最后,水位上升,流速减慢。” 明确物理规则: 在提示词中直接嵌入物理常识。例如:“根据重力加速度,球下落的速度应该越来越快”或“流体具有粘性,流动时会有拉丝效果”。 回溯修正: 如果第一版视频不符合物理规律(比如球浮在空中),你可以通过反馈指令让系统进行“回溯推理”,识别出视频与物理规则的语义不匹配,并自动修正提示词重新生成。 3. 参数化控制:像物理老师一样给定数值 ? 如果你需要极其精确的物理运动(例如做科学实验模拟或电影特效),可以使用类似普渡大学 NewtonGen 框架的思路,直接给定物理参数。 设定初始状态: 在语言描述中包含具体的物理量。 位置与速度: “一个小球从坐标 (0, 10) 以初速度 5m/s 水平抛出”。 角度与旋转: “一个陀螺以角速度 10rad/s 旋转”。 质量与材质: “一个轻质的泡沫块”与“一个沉重的铁球”在相同力作用下的反应是不同的。 指定运动类型: 明确指出是“匀速直线运动”、“抛物线运动”还是“圆周运动”。AI 会根据这些语义,调用内置的“神经物理引擎”来计算轨迹,确保视频中的物体运动轨迹符合牛顿定律。 4. 结合物理引擎的混合描述:虚实结合 ? 更高级的方法是让语言描述直接驱动物理模拟器(如 Blender, Genesis),然后将结果渲染成视频。 描述物理属性: 在提示词中指定物体的密度、弹性系数、摩擦力等。 事件驱动描述: 描述物体间的相互作用。例如:“一个刚性的小球撞击一个柔软的布料,布料发生形变并包裹住小球”。 通用物理引擎: 像 Genesis 这样的新模型,允许你用自然语言描述复杂的物理场景(如“一滴水滑落”),它能直接生成符合流体动力学的模拟数据,而不仅仅是看起来像视频的图像帧。 ? 总结:如何写出“物理级”提示词? 为了更直观地掌握这种描述方式,这里总结了一个对比表: 一句话总结: 要用语言描述物理运动,关键在于将“视觉结果”转化为“物理过程”。多用描述力(风、推力)、属性(重力、粘性)、参数(速度、角度)的词汇,甚至直接告诉 AI 要遵循某种物理规律,这样生成的视频才会有真实的“重量感”和“真实感”。

9 个月前
利用大语言模型(LLM)构建虚拟的“世界模型”(World Models),以此作为 KI 智能体(AI Agents)积累经验和训练的场所。 核心概念:让 LLM 成为 AI 的“模拟练习场” 目前,开发能在现实世界执行复杂任务的 AI 智能体(如机器人、自动化软件助手)面临一个巨大挑战:获取实际操作经验的成本极高且充满风险。 如果让机器人在物理世界中通过“试错”来学习,不仅效率低下,还可能造成硬件损毁。 研究人员提出的新思路是:利用已经掌握了海量人类知识的大语言模型(LLM),由它们通过文字或代码生成一个模拟的“世界模型”。 1. 什么是“世界模型”? 世界模型是一种模拟器,它能预测特定行为可能产生的结果。 传统方式: 需要开发者手动编写复杂的代码来定义物理法则和环境规则。 LLM 驱动方式: 预训练的大模型(如 GPT-4 或 Claude)已经具备了关于世界运行逻辑的知识(例如:知道“推倒杯子水会洒”)。研究人员可以利用 LLM 自动生成这些模拟环境的逻辑。 2. 研究的具体内容 来自上海交通大学、微软研究院、普林斯顿大学和爱丁堡大学的国际研究团队对此进行了深入研究。他们测试了 LLM 在不同环境下充当模拟器的能力: 家庭模拟(Household Simulations): 模拟洗碗、整理房间等日常任务。 电子商务网站(E-Commerce): 模拟购物行为、库存管理等逻辑。 3. 关键发现: 强结构化环境表现更佳: 在规则清晰、逻辑严密的场景(如简单的文本游戏或特定流程)中,LLM 驱动的模拟效果非常好。 开放世界的局限性: 对于像社交媒体或复杂的购物网站这类高度开放的环境,LLM 仍需要更多的训练数据和更大的模型参数才能实现高质量的模拟。 真实观察的修正: 实验显示,如果在 LLM 模拟器中加入少量来自现实世界的真实观察数据,模拟的质量会显著提升。 对 AI 行业的意义 加速 AI 智能体进化: 这种方法让 AI 智能体可以在几秒钟内完成数千次的虚拟实验,极大加快了学习速度。 降低训练门槛: 开发者不再需要搭建昂贵的物理实验室,只需要调用 LLM 接口就能创建一个“训练场”。 2026 年的趋势: 这预示着 2026 年及以后,“自主智能体”将成为 AI 发展的核心,而这种“基于模拟的学习”将是通往通用人工智能(AGI)的关键一步。 总结 该研究证明,LLM 不仅仅是聊天机器人,它们可以演变成复杂的“数字世界创造者”。在这个虚拟世界里,新一代的 AI 智能体可以安全、低成本地反复磨练技能,最终再将学到的能力应用到现实生活和工作中。 ( 根据海外媒体编译 )
11 个月前
LoRA(Low-Rank Adaptation)是一种对大模型进行“轻量级微调”的技术。